요약
⏱ 00:001. AI 데이터 센터와 메모리 장벽
⏱ 00:00AI 데이터 센터는 작은 도시 하나에 맞먹는 전력을 소비하지만, 세계에서 가장 비싼 프로세서인 GPU가 상당 시간 유휴 상태로 머문다고 영상은 지적합니다. 원인은 연산 속도를 데이터 공급이 따라가지 못하는 데 있습니다.
⏱ 01:022. 파라미터 이동과 DRAM 병목
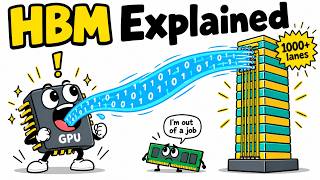
⏱ 01:02거대 언어 모델은 수천억 개의 파라미터를 가지며, 단어 하나를 생성할 때마다 방대한 양의 파라미터를 메모리에서 끌어와야 합니다. 영상은 GPU를 천 차선 고속도로, 전통적 DRAM을 1차선 다리에 비유합니다. 출구 너비가 교통량을 제한하듯 기존 DRAM 인터페이스의 폭이 전체 처리량을 제한하며, 전선을 물리적으로 넓히는 데에는 한계가 있습니다.
⏱ 02:163. HBM의 3D 적층 구조
⏱ 02:16HBM의 핵심은 메모리 칩을 기판에서 떼어 프로세서 옆, 같은 패키지 안에 배치하는 것입니다. 공간을 줄이기 위해 메모리 칩을 웨이퍼처럼 얇게 썰어 수직으로 쌓고, 층마다 수천 개의 실리콘 관통 전극(TSV) 구리 기둥을 뚫어 데이터를 위아래로 전달합니다.
⏱ 03:274. 발열 문제와 삼성의 인증 실패
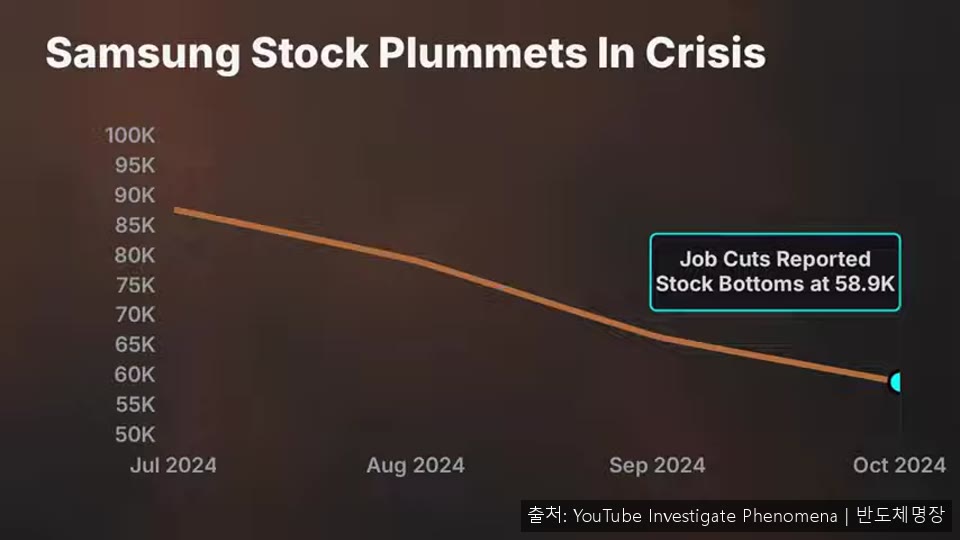
⏱ 03:27칩을 여러 층 쌓으면 중간 층에 열이 갇혀 부품이 휘거나 고장 날 수 있다는 것이 가장 큰 문제입니다. 영상에 따르면 삼성전자는 1세대 HBM을 엔비디아에 공급했지만, 최신 AI용 고속 칩의 품질 인증 단계에서 스택이 과열되어 테스트를 통과하지 못했습니다.
⏱ 04:405. 통합 설계를 통한 재도전
⏱ 04:40영상은 삼성이 검증된 12나노 공정 대신 메모리 층에는 아직 검증되지 않은 10나노급 공정을, 베이스 다이에는 최첨단 4나노 노드를 택했다고 설명합니다. 메모리 엔지니어와 파운드리 엔지니어가 함께 일하며 메모리와 로직 베이스를 하나의 통합 시스템으로 설계했습니다.
4나노 공정은 복잡하고 비용이 많이 들었으며, 수율 문제가 생기면 대안이 없는 도박이었습니다. 그러나 고급 로직 베이스로 수직 배선의 전압을 낮춰 핵심 층의 발열을 줄였고, 업계 표준보다 46% 빠른 데이터 속도를 구현했다고 합니다.
⏱ 06:206. 양산 복귀와 실적 회복
⏱ 06:202026년 초 삼성의 새 설계는 까다로운 검증 테스트를 통과해 엔비디아 차세대 AI 플랫폼 베라 루빈용 양산에 들어갔다고 합니다. 영상이 보여주는 분기별 영업이익 차트에서는 새 메모리 출하가 시작되며 수익이 급격히 늘어난 모습이 확인됩니다.
영상은 2026년 3분기까지 누적 영업이익이 107조 1천억 원, 약 800억 달러에 이른다고 전하며, 삼성이 SK하이닉스를 제치고 시장 점유율 1위를 되찾았다고 설명합니다.
⏱ 06:557. 공급 구조의 제약과 경쟁
⏱ 06:55HBM을 상업적 규모로 만들 수 있는 곳은 SK하이닉스, 마이크론, 삼성 세 곳뿐이며, 3D 패키징에 필요한 설비 구축 비용은 매우 큽니다. 공급사들은 클라우드 업체의 데이터 센터 투자 확대에 맞춰 막대한 자본을 묶어두고 있습니다.
외부에서는 CXMT 같은 중국 제조사들이 메모리 셀을 축소해 고밀도 구조를 실험하고 있으며, 국제 경쟁도 가격 압박을 키우고 있습니다. 영상은 생성형 AI의 한계가 소수 기업이 발열을 관리하며 실리콘 고층 구조를 계속 만들어낼 수 있는지에 달려 있다고 맺습니다.