
요약
⏱ 00:001. 서론: 칩 성능과 시스템 처리량
⏱ 01:072. 계산과 데이터 이동의 기본 모델
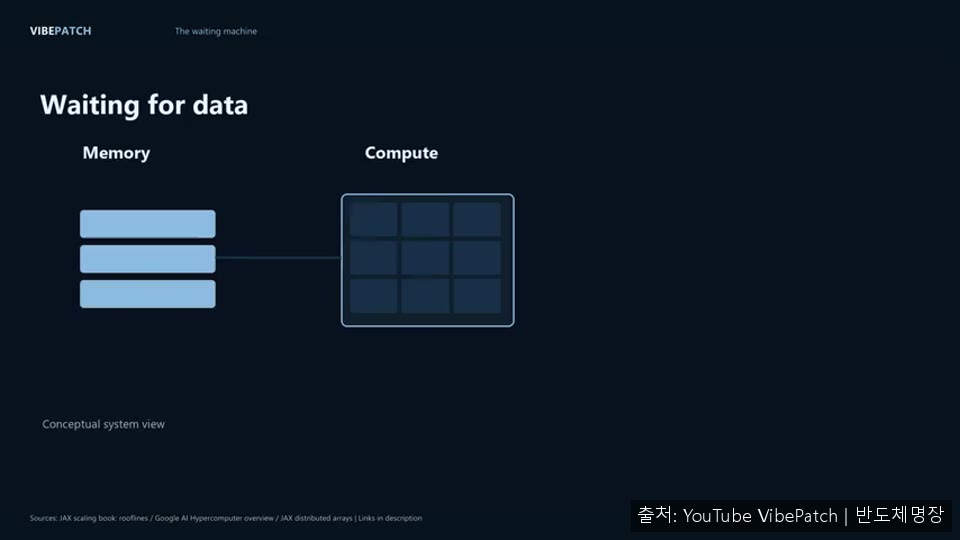
⏱ 01:07계산 시간은 연산량과 하드웨어 처리율에, 데이터 이동 시간은 전송량과 대역폭에 좌우된다. 두 작업이 일부 겹칠 수 있어도 더 느린 쪽이 결과를 제한한다. roofline은 이런 한계를 보여주는 틀이지 보편적인 유휴율을 뜻하지 않는다.
⏱ 02:363. 메모리 관리, 컴파일러, 장치 간 통신
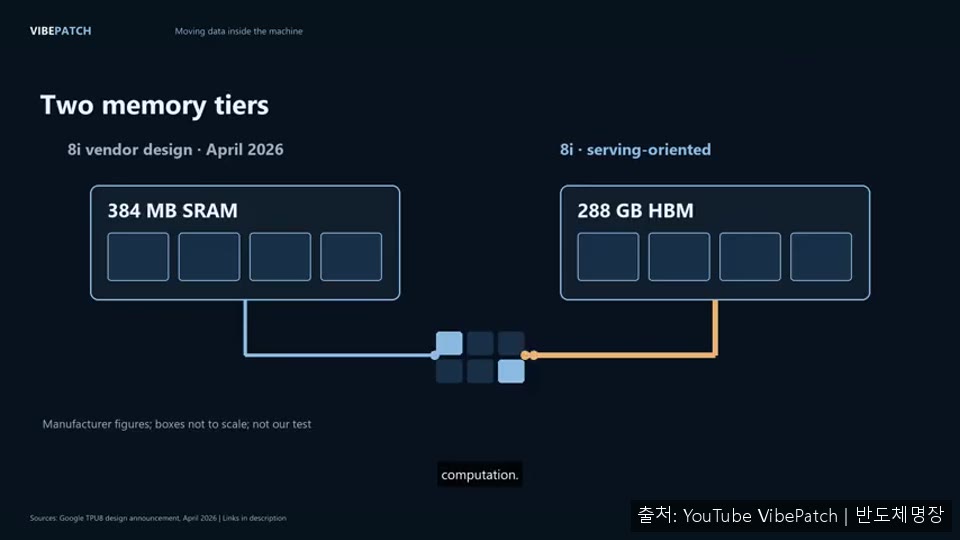
⏱ 02:36언어 모델의 attention cache는 요청이 길어지고 동시 작업이 늘수록 메모리를 압박한다. PagedAttention은 이 공간을 더 효율적으로 관리하는 방법이지, 무제한 저장소를 만들어 주지는 않는다. OpenXLA 같은 컴파일러는 연산을 변환하고 결합해 장치에 맞는 구현을 고르지만, 여러 백엔드를 지원한다는 사실이 같은 속도를 보장하지는 않는다.
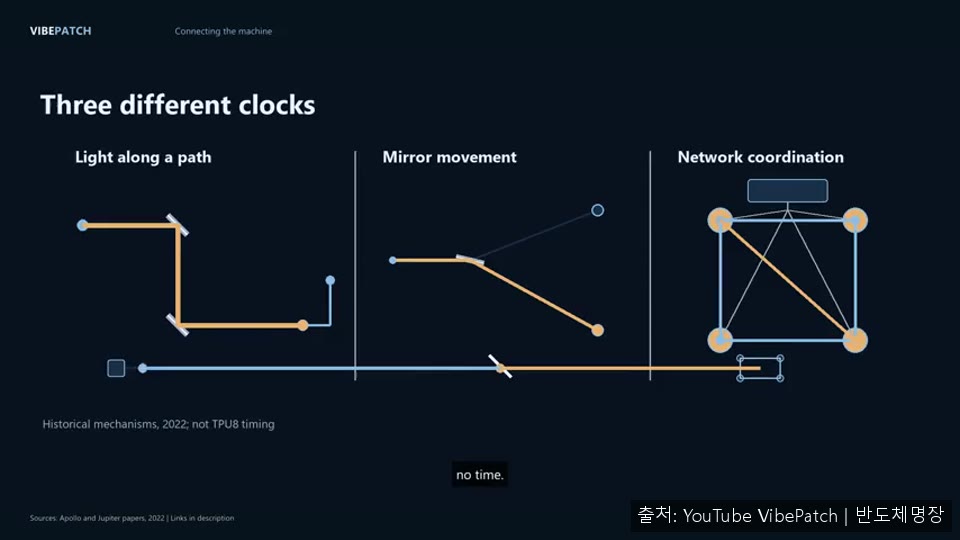
장치를 나누면 JAX 같은 도구가 집합 통신 연산을 삽입한다. 자동 병렬화가 배치를 도와도 교환해야 할 데이터는 사라지지 않는다. 4세대 TPU 연구는 고정 전기 연결과 재구성 가능한 광 경계를 결합했으며, 특정 배치에서 특정 통신 패턴을 지원했다. 칩 간 링크, 대형 네트워크, 스토리지 경로는 서로 다른 경로이므로 대역폭 수치를 서로 바꿔 쓸 수 없다. 광 스위치는 미세한 거울로 빛의 경로를 바꾸지만, 경로 변경과 제어 시스템의 조정에는 여전히 시간이 든다.
⏱ 05:464. 자원 할당과 장애 복구
⏱ 05:46작업을 실행하려면 하드웨어 세대, 크기, 영역, 쿼터, 소비 옵션을 먼저 정해야 한다. 온디맨드 용량이 항상 확보되는 것은 아니며, 일부 옵션에는 추가 접근 조건이 붙는다. 클라우드 콘솔의 요청은 할당 과정의 시작일 뿐이다.
실행 중 장애가 나면 멀티 호스트 텐서 슬라이스가 영향을 받을 수 있다. 인프라를 복구하는 일과 모델, 옵티마이저, 데이터 위치를 되살리는 일은 별개의 작업이다. Pathways 패턴은 복제된 학습 상태를 호스트 메모리 스냅샷으로 보존하고, 살아남은 복제본에서 상태를 가져와 활성 메쉬를 다시 구성한다. 이를 위해서는 주기적 스냅샷과 재시도 로직이 필요하다. goodput 측정은 실제 학습 진행을 초기화, 컴파일, 데이터 대기, 저장, 복구 시간과 구분한다.
⏱ 08:125. 서빙, 벤치마크, 전력 측정의 경계
⏱ 08:12프롬프트 처리와 이후 토큰 생성은 자원 요구가 다르다. 사용자는 첫 토큰까지의 대기와 이후 토큰 간의 간격을 함께 경험한다. 2024년 DistServe 연구는 두 단계를 분리하면서 네트워크 대역폭과 지연 목표를 고려했다. 따라서 유용한 서빙 용량은 두 목표를 모두 만족하며 처리한 작업량으로 정의해야 한다.
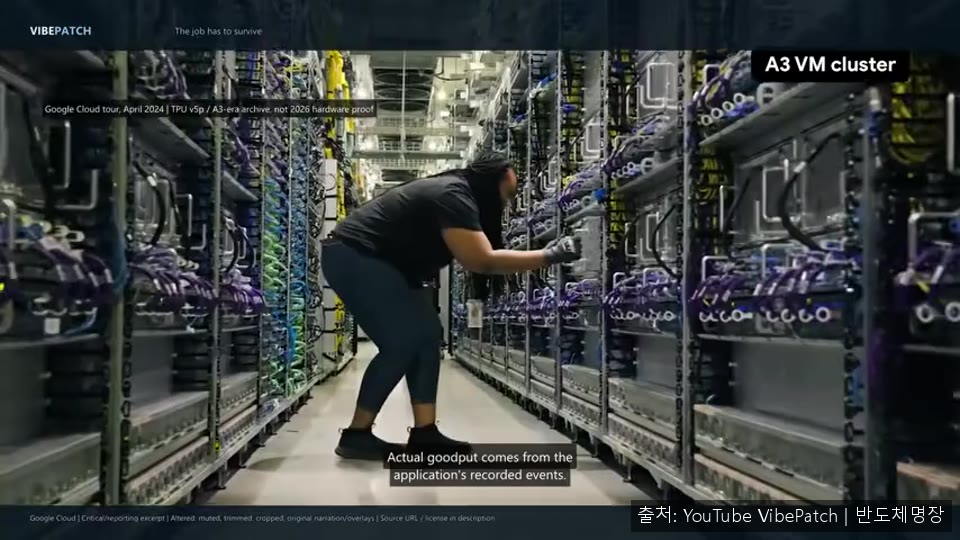
MLPerf inference 방법론은 작업, 품질 요건, 요청 시나리오, 성능 제약을 명시한다. 전력은 벤치마크 중 테스트 시스템의 전기 입력으로 측정하므로 칩의 정격 전력을 인용하는 것보다 경계가 명확하다. 그래도 결과가 전체 데이터센터를 자동으로 포함하지는 않는다.
⏱ 09:256. 환경 보고, 플랫폼 통합, 비교 기준
⏱ 09:25구글의 2026년 환경 보고서는 2025년을 다룬다. 전력 수요는 37% 증가했고, Scope 1과 market-based Scope 2 기준 운영 배출은 2% 감소했다. 전력과 배출은 서로 다른 것을 측정하며, 83% 절감은 연산 외 오버헤드 에너지 기준이고 냉각과 전력 분배가 포함된다. 이 연간 수치로 모델 답변 하나당 전력이나 TPU와 GPU의 대응 비교를 확정할 수 없다.
2026년 10월 21일 구글은 NVIDIA Vera Rubin 플랫폼 기반 A5X 시스템을 발표하며 다음 달 일반 제공을 예고했다. 이는 NVIDIA가 같은 인프라 전략 안에 들어갔음을 보여준다. 다만 발표일은 계획을 알려줄 뿐이고, 고객이 필요한 제품과 지역의 실제 가용성은 따로 확인해야 한다. 평가할 때는 유용한 완료 작업, 명시된 지연 목표, 경계가 정해진 에너지 측정, 그리고 하드웨어와 소프트웨어 구성을 함께 확인해야 한다.


