
요약
⏱ 00:001. 루빈의 개요와 블랙웰 대비 주장
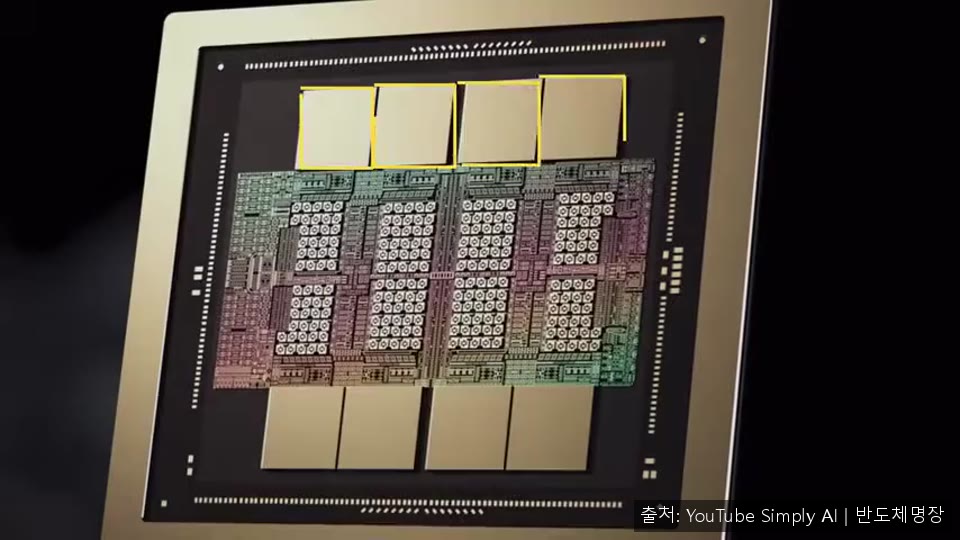
⏱ 00:00루빈은 엔비디아가 블랙웰의 후속으로 내놓은 AI 칩입니다. 칩 주변에 배치된 8개의 새 메모리 스택이 블랙웰보다 약 2.5배 빠른 데이터 공급을 맡고, 칩 72개가 하나의 랙을 채우는 구성입니다. 엔비디아는 블랙웰 랙 대비 AI 서비스 제공 비용을 최대 10배 낮출 수 있다고 주장합니다.
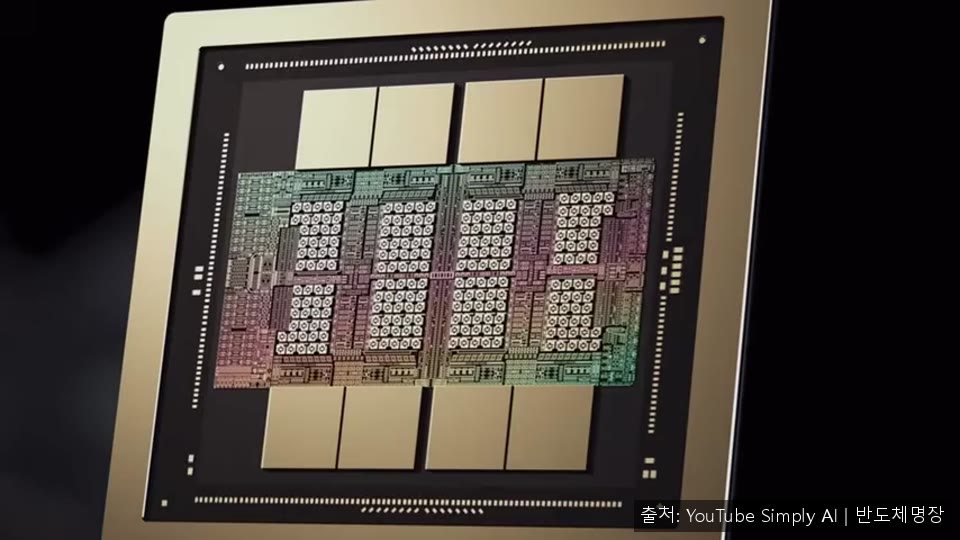
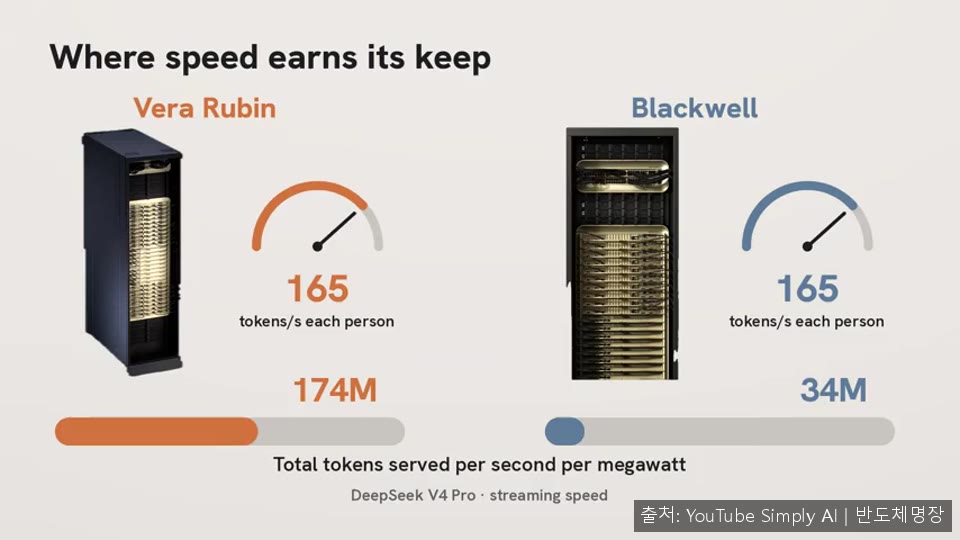
독립 테스트에서는 최신 블랙웰 랙과 비교했습니다. 모든 답변을 빠르게 출력하도록 설정하면 블랙웰은 처리 성능의 대부분을 잃지만 루빈은 성능을 상당 부분 유지했습니다. 반면 사용자가 가득 찬 상태에서 답변 속도를 낮추면 두 랙의 격차는 1.5배 미만으로 줄어들어, 루빈의 강점은 주로 빠른 응답 구간에서 드러납니다.
⏱ 01:542. 메모리 병목과 HBM4
⏱ 01:54AI가 토큰을 하나 만들 때마다 칩은 모델의 수치를 메모리에서 다시 읽어 와야 합니다. 그래서 전체 속도가 연산 속도보다 메모리 속도에 좌우되는 '메모리 바운드' 상태가 됩니다. 루빈은 블랙웰과 같은 288GB 용량을 갖추면서 초당 약 19TB를 이동시켜, 블랙웰의 8TB보다 두 배 이상 빠릅니다. 엔비디아는 처음 약속보다 사양을 일부 낮췄다고 알려졌지만 여전히 큰 차이가 있습니다.
⏱ 03:183. 베라 프로세서와 캐시 구조
⏱ 03:18루빈 칩 두 개마다 엔비디아의 자체 프로세서 베라(Vera)가 하나씩 배치됩니다. 베라는 용량은 크지만 속도가 느린 별도 메모리 풀을 갖고 있습니다. 코딩 세션에서는 거의 모든 요청이 이전 대화를 반복하므로, 지금까지의 대화 기록을 캐시(KV cache)로 저장해 재사용하게 됩니다. 테스트에서는 이 캐시 대부분을 베라의 메모리에 보관했고, 칩과 프로세서를 잇는 링크가 블랙웰보다 두 배 빠른 점이 이 구조를 뒷받침합니다.
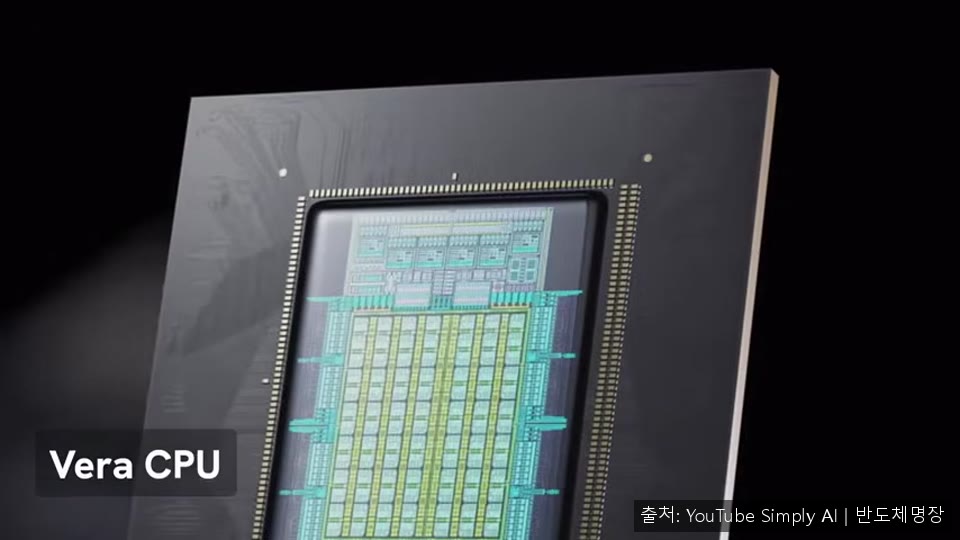
이 구조의 장점은 긴 맥락을 가진 작업에서 매번 전체 기록을 다시 계산하지 않아도 된다는 점입니다. 다만 캐시를 저속 메모리에 두면 첫 토큰이 나오기까지 지연이 생길 수 있어, 응답 시작 속도와 전체 처리량 사이의 균형이 설계의 핵심 쟁점이 됩니다.
⏱ 04:004. 대형 MoE 모델과 NVLink
⏱ 04:00딥시크의 가장 큰 모델은 약 1.6조 개의 숫자로 구성되어 칩 하나의 메모리에 들어가지 않습니다. 그래서 테스트에서는 최대 32개의 루빈 칩에 나누어 올렸습니다. 이런 모델은 전문가(experts)라 불리는 작은 부분으로 나뉘고, 각 토큰은 그중 일부 전문가만 방문합니다. 그 전문가들은 보통 다른 칩에 있어 토큰이 칩 사이를 왕복하게 되므로, 이동이 느리면 모든 칩이 대기하게 됩니다.
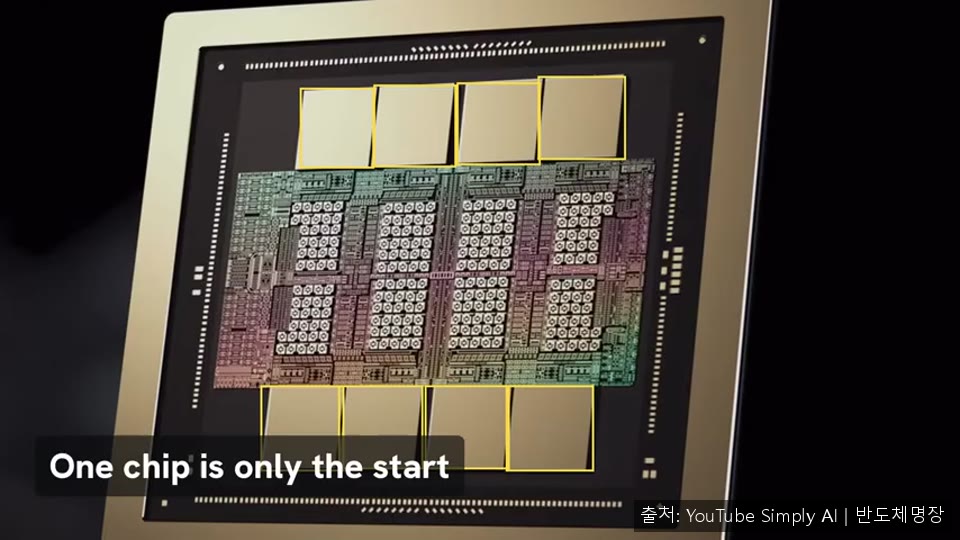
이 때문에 칩 간 연결망인 NVLink의 속도가 거대 모델의 응답 속도를 좌우합니다. 루빈은 6세대 NVLink를 도입해 칩당 약 3TB/s를 전송하며, 블랙웰 최신형의 1.8TB/s보다 빠릅니다. 랙 전체에서는 약 216TB/s로 소개되었습니다.
⏱ 05:185. 랙 설계: 구리 스파인과 액체 냉각
⏱ 05:18랙 후면의 스파인은 광섬유가 아닌 구리로 만들어졌습니다. 젠슨 황은 그 안에 약 2마일 길이의 구리 케이블 5,000개가 들어 있다고 설명했습니다. 트레이는 케이블, 호스, 팬 없이 스파인과 수로에 바로 결합되는 구조입니다. 랙 하나의 소비 전력은 약 240kW이며, 이 전력은 모두 열로 바뀌어 물을 통해 배출됩니다. 그 물 때문에 무게도 늘어나, 전시용 랙은 물을 빼는 것을 잊어 2톤이 아닌 2.5톤이 나갔다는 일화도 전해졌습니다.
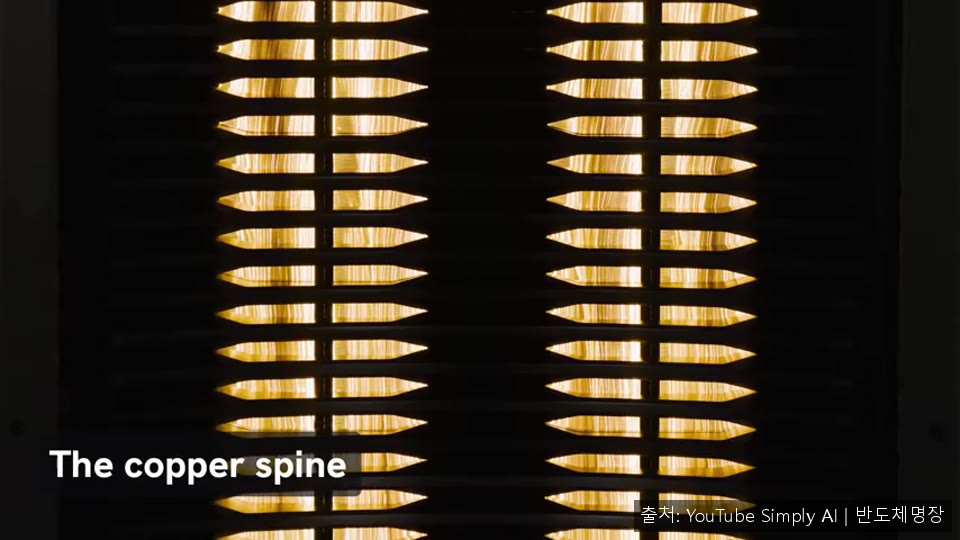
이처럼 랙 전체를 하나의 칩처럼 묶는 설계는 전력과 냉각 요구를 크게 높입니다. 따라서 루빈의 성능 향상은 칩 자체뿐 아니라 배선, 냉각, 구조물을 함께 바꾼 결과로 볼 수 있습니다.
⏱ 06:006. 세 가지 수치의 해석과 비용 주장
⏱ 06:00엔비디아는 루빈을 세 가지 수치로 홍보하는데, 각각 측정 대상이 다릅니다. 랙 단위 3.3배와 칩 단위 5배는 모두 이론상 연산량을 단순 계산한 값입니다. 같은 방식으로 계산하면 각각 블랙웰 최신 랙 대비 두 배 조금 넘는 수준, 기존 블랙웰 칩 대비 약 3.5배로 낮아집니다. 루빈의 최상의 사례(모델 일부가 0일 때 건너뛸 수 있는 연산 포함)와 블랙웰의 일반 사례를 비교했기 때문입니다.
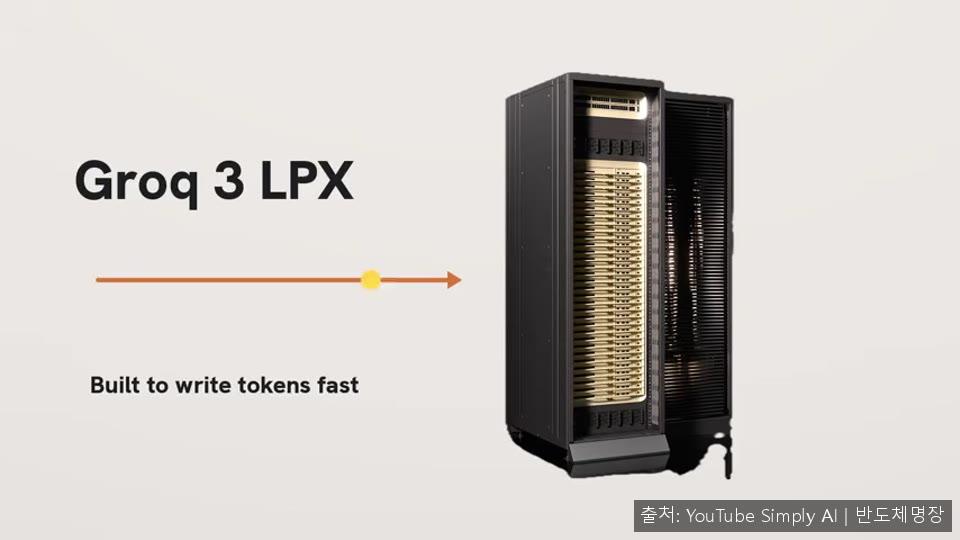
토큰당 비용 10배 절감은 엔비디아 자체 테스트에서 나온 수치로, 구형 블랙웰 랙과 비교한 결과입니다. 클라우드 업체 코어위브(CoreWeave)는 자체 측정에서 같은 속도 기준 메가와트당 토큰 처리량이 구형 블랙웰보다 최대 10배 많았다고 밝혔습니다. 다만 이는 출발점일 뿐이며, 이 수치들이 곧바로 실제 이용 비용의 절감을 뜻하지는 않습니다.
⏱ 08:007. 추론 수요 변화와 출하 일정
⏱ 08:00최근 AI 모델은 답변 전에 사고 과정을 먼저 작성하고, 코딩 에이전트는 수 분간 여러 단계를 실행하기도 합니다. 학습된 모델을 실행하는 추론 단계가 늘수록 속도가 사용자 경험과 비용을 좌우하게 되며, 빠른 응답 모드나 긴 작업을 처리하는 서비스가 가장 큰 이득을 볼 것으로 보입니다. 분석 업체 세미애널리시스는 대부분의 제공 업체 속도에서 달러당 성능이 1.4배에서 3배 향상될 것으로 예상했지만, 가격 인하를 약속한 곳은 없습니다.
루빈은 8월부터 출하되었고, 코어위브와 오라클이 먼저 대여를 시작했으며 구글은 11월부터 도입할 예정입니다. 앤스로픽(Anthropic)의 랙은 2027년 후반에 가동될 계획입니다. 코딩 에이전트에서는 느린 첫 토큰이 여전히 병목이므로, 다음 소프트웨어 업데이트가 이를 얼마나 줄이는지가 주목할 지점입니다.


