요약
⏱ 00:031. 주문형 HBM의 등장 배경
⏱ 00:03영상은 올해 말 삼성전자가 주문형(커스텀) HBM 양산을 시작할 수 있다는 흐름을 짚으며 논의를 엽니다. 핵심은 HBM4가 하나가 아니라 범용 표준형과 고객 주문형(CHBM)으로 나뉘기 시작했다는 점입니다.
⏱ 03:132. 표준 HBM과 주문형 HBM의 구조 차이
⏱ 03:13영상은 주문형 HBM이 기존 표준을 깨는 세 가지 변화를 가진다고 설명합니다. 첫째, 메모리 맨 아래 베이스 다이의 역할을 줄이고 이를 큰 다이 중심으로 통합하는 방향입니다. 둘째, 채널 제어를 프로세서가 아니라 메모리가 스스로 담당하는 자율 관리 구조입니다. 셋째, 단순 연산이나 데이터 정리 작업을 메모리 쪽으로 옮기는 방식입니다.
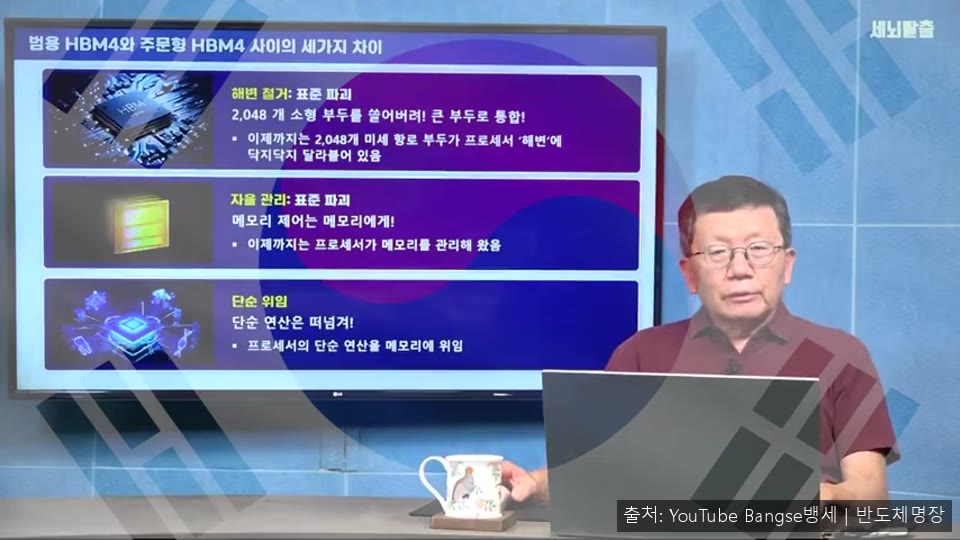
이렇게 되면 프로세서와 메모리를 잇는 신호 연결 부담이 낮아진다는 것이 영상의 설명입니다. 다만 사양이 발주자 요구에 따라 정해지므로 고객과 설계를 협의하는 과정이 필수적이라고 덧붙입니다.
⏱ 04:583. 엔비디아와 하이퍼스케일러의 입장 차이
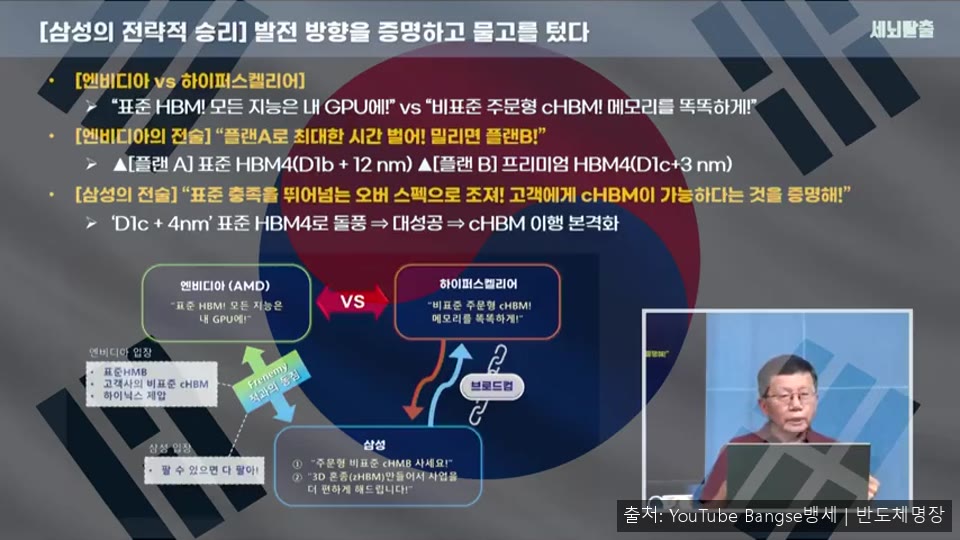
⏱ 04:58영상은 GPU를 직접 파는 엔비디아와 자체 클라우드 서비스를 운영하는 하이퍼스케일러의 이해관계가 다르다고 봅니다. 엔비디아는 자사 GPU 생태계를 지키기 위해 범용 표준 HBM을 유지하려 하고, 하이퍼스케일러는 서비스 효율을 위해 메모리가 더 똑똑해지길 원한다는 논리입니다.
⏱ 09:174. Z-HBM: 메모리 위에 GPU를 올리는 3D 혼종 구조
⏱ 09:17영상이 소개하는 Z-HBM은 GPU 기능을 여러 개의 작은 연산 칩으로 나눠 HBM 적층 위에 올리는 3D 혼종 구조입니다. 기존에는 하나의 큰 GPU 다이와 여러 HBM이 같은 기판 위에 나란히 놓였지만, 이 구조에서는 메모리 적층과 연산 칩이 수직으로 겹칩니다.
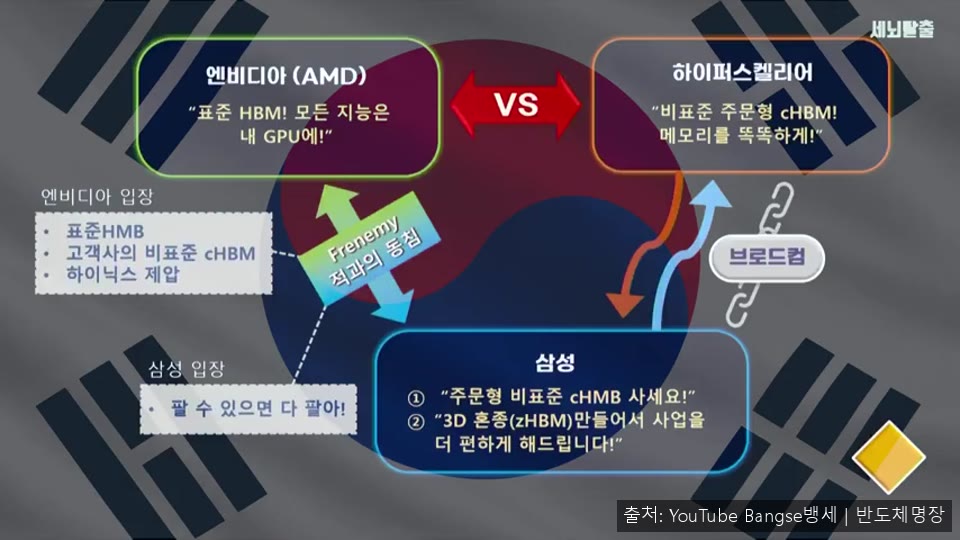
영상은 메모리 칩 면적이 작은 반면 GPU는 훨씬 크다는 점을 들어, 작은 연산 타일을 여러 장 배치하면 같은 면적에 연산 자원을 더 촘촘히 배치할 수 있다고 설명합니다. 다만 칩 사이 연결 기술과 발열 관리가 새로운 과제가 된다고 짚습니다.
⏱ 11:565. 전송 속도와 발열이 만드는 개발 난제
⏱ 11:56영상은 고속 데이터 전송이 HBM 개발의 핵심 난관이라고 설명합니다. 신호 속도가 임계치를 넘으면 발열과 전자파 문제가 커지고 신호 안정성이 떨어지기 때문에, 전송 속도를 높이면서도 안정적으로 동작시키는 설계가 중요하다는 것입니다.
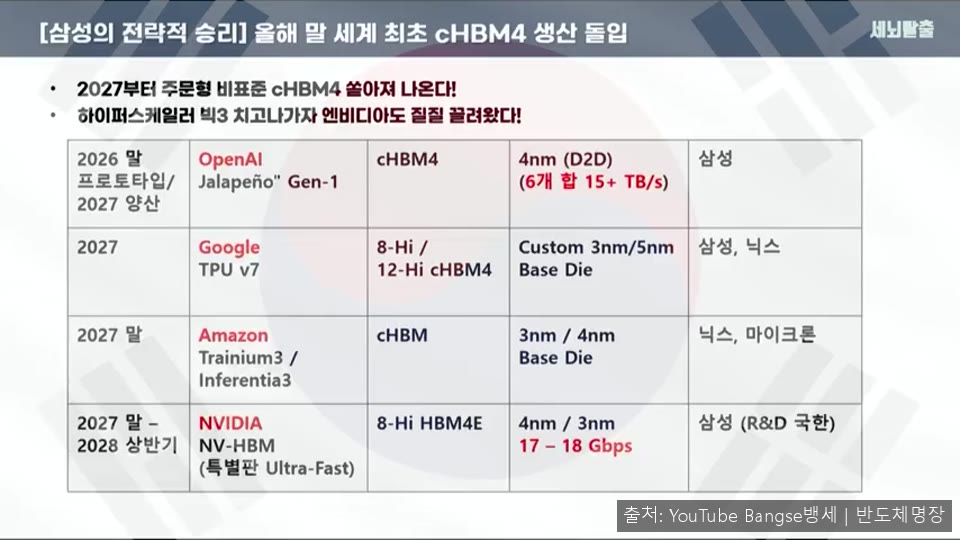
영상에서는 주문형 HBM의 목표가 속도를 극단적으로 올리기보다 적정 동작 속도에서 데이터 처리량을 꾸준히 확보하는 데 있다고 봅니다. 이를 위해 메모리 쪽에서 연산을 미리 처리해 넘기는 방식도 함께 거론됩니다.
⏱ 14:446. 랙과 트레이 구조, 면적 비교
⏱ 14:44영상은 현재 AI 서버의 트레이 구조를 예로 듭니다. 한 트레이에 대형 GPU 한 개와 HBM 여러 개가 함께 올라가 있고, 면적으로 보면 GPU가 가장 큰 비중을 차지합니다. 트레이 하나가 쓰는 전력이 약 4kW 수준이라는 설명도 함께 나옵니다.
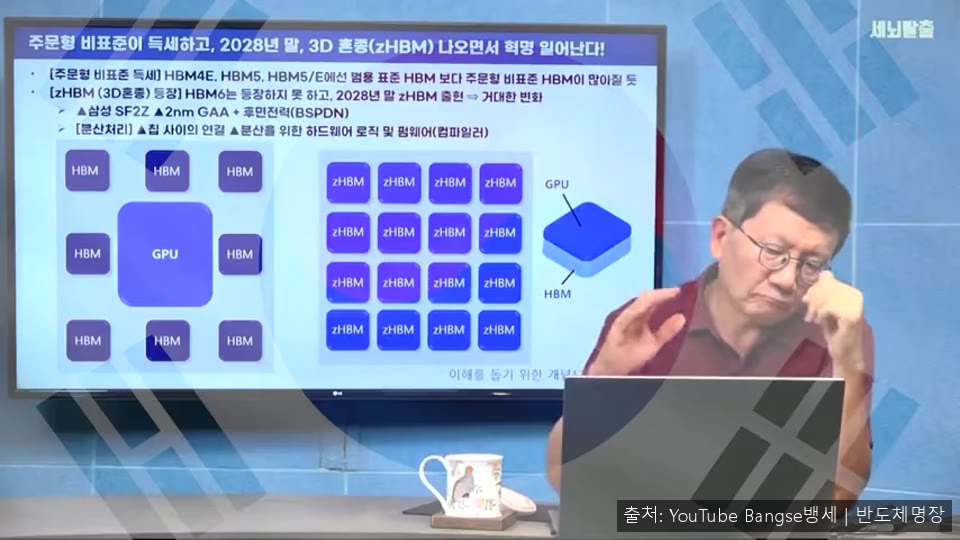
Z-HBM 구조에서는 작은 GPU 타일을 여러 개 배치해 연산 면적을 늘리고, 칩 사이 거리가 짧아져 데이터 이동에 드는 전력과 열을 줄일 수 있다는 논리입니다. 영상은 이 구조가 여러 기업의 협력으로 완성되는 아키텍처 변화라고 설명합니다.
⏱ 24:367. 빅다이 수율이라는 시험 문제
⏱ 24:36마지막으로 영상은 삼성이 맞닥뜨린 과제로 빅다이 생산을 꼽습니다. 삼성은 모바일 AP 등 면적이 상대적으로 작은 스몰다이 생산 경험은 많지만, 800mm² 안팎의 대형 다이 제작 경험은 적다는 설명입니다.
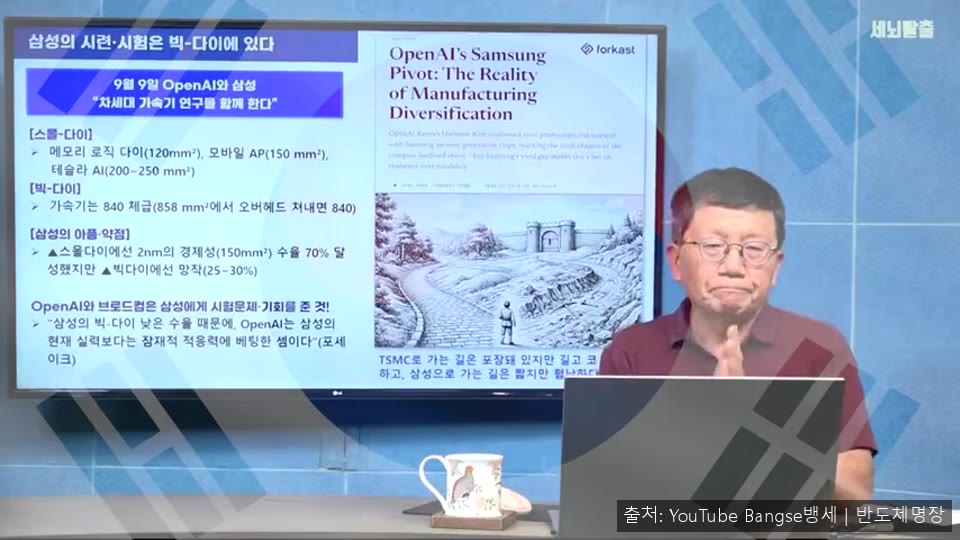
영상은 면적이 커질수록 웨이퍼 한 장에서 정상 칩을 얻는 비율인 수율이 급격히 떨어지기 때문에, 스몰다이에서 나온 높은 수율을 그대로 적용하기 어렵다고 설명합니다. 관련 매체의 해석을 인용하며 이 부분이 주문형 빅다이 검증의 핵심 관문이라고 정리하고, 향후 결과를 지켜볼 지점으로 짚습니다.