요약
⏱ 00:001. 나노 숫자 경쟁의 한계
⏱ 00:00육상 경기처럼 숫자로 승패가 갈린다는 믿음이 반도체에도 오랫동안 통했다. 7나노, 5나노, 3나노처럼 숫자가 작을수록 앞선 기술이라는 인식이다. 하지만 영상은 2028년 양산을 목표로 한 1.4나노급 파운드리 경쟁에서 승부처가 더 이상 나노미터 크기에 있지 않다고 짚는다. 노드 명칭이 물리적 치수보다 마케팅 용어에 가까워졌다는 것이다.
⏱ 01:582. 7.5배 생산능력 전망의 의미
⏱ 01:58TSMC의 2028년 A14 생산능력이 인텔 14A보다 7.5배 이상 클 것이라는 분석이 제시된다. 영상은 이를 기술력이나 양품 수율의 격차로 읽으면 안 된다고 강조한다. 이 수치는 제조 규모와 공급 안정성을 보여주는 지표다.
⏱ 05:313. TSMC의 점진적 진화 전략
⏱ 05:31선두 TSMC는 안정성과 점진적 진화를 택했다. A14는 기존 2나노 계열 공정 대비 같은 전력에서 속도를 10~15% 높이거나, 같은 속도에서 전력을 25~30% 줄이는 것을 목표로 한다고 소개된다.
⏱ 07:464. 인텔 14A의 고위험 승부
⏱ 07:46인텔은 정반대의 길을 간다. 차세대 트랜지스터 구조인 리본펫, 후면 전력 공급 기술인 파워 다이렉트, 그리고 ASML의 하이 NA EUV 장비를 14A에 한꺼번에 투입했다는 것이다.
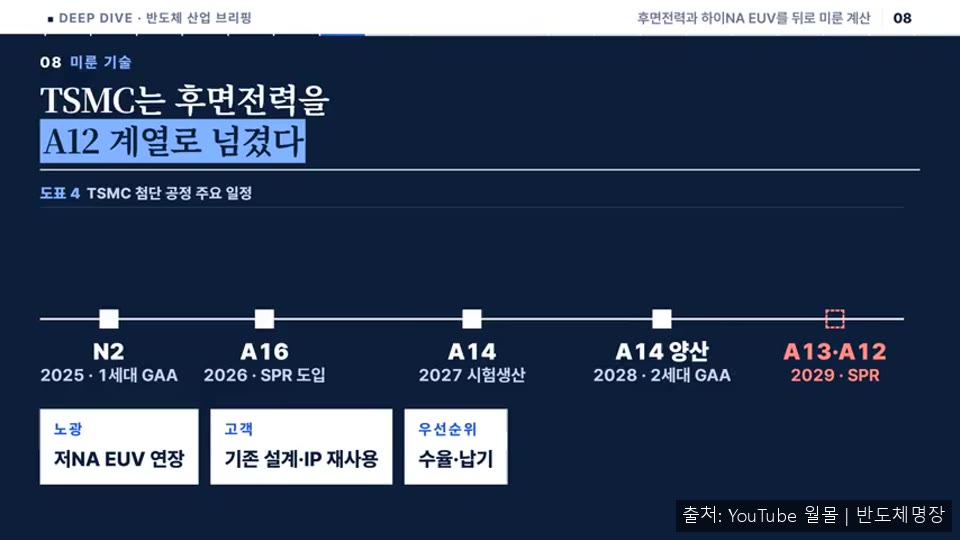
영상은 그 배경으로 인텔 파운드리가 TSMC처럼 대규모 외부 고객 기반을 갖고 있지 않다는 점을 든다. 후발 주자는 기존 고객을 끌어오려면 확실한 기술 차별화를 먼저 보여야 한다. 하이 NA는 렌즈 개구수를 키워 빛을 더 정밀하게 모으는 장비로, 여러 번 나눠 그리는 다중 패터닝 횟수를 줄여 공정을 단순화할 수 있다고 설명된다. 다만 장비 가격이 매우 높아 투자 회수를 위해 외부의 대량 고객 확보가 필수다. 신기술 세 가지를 동시에 융합해 수율까지 끌어올려야 하는 난이도도 크다. 영상은 ASML 장비의 누적 웨이퍼 100만 장 처리 실적이 개발과 인증용 테스트 성과이며, 상용 양산 성공을 뜻하지는 않는다고 덧붙인다.
⏱ 11:085. S램 병목과 면적 축소의 한계
⏱ 11:08칩 내부에는 공정 미세화만으로 풀리지 않는 병목이 있다. 연산 회로 바로 옆에 붙어 자주 쓰는 데이터를 보관하는 S램, 즉 캐시 메모리다. 메인 메모리까지 데이터를 가져오면 느리고 전력도 많이 쓰기 때문에 AI 칩에서 S램의 역할이 크다. 영상은 요리할 때 창고 대신 싱크대 옆 미니 냉장고를 두는 것에 비유한다.
문제는 S램이 로직 회로만큼 줄지 않는다는 점이다. 영상이 인용한 연구 자료에서 차세대 S램 비트 면적은 기존 세대 대비 약 19% 축소되는 데 그친다. S램은 1비트를 저장하기 위해 최소 여섯 개의 트랜지스터가 복잡하게 맞물려야 하고, 너무 좁게 만들면 신호 간섭으로 데이터가 깨진다. 결국 연산부는 작아지는데 칩 면적의 절반 가까이를 차지하는 S램은 그대로 남아, 칩 크기와 원가가 기대만큼 줄지 않는다는 문제가 생긴다.
⏱ 14:526. DTCO와 첨단 패키징
⏱ 14:52S램 병목을 칩 내부 미세화로 풀기 어려워지자 업계는 설계 단계부터 공정과 함께 최적화하는 DTCO로 눈을 돌린다. 과거에는 파운드리가 공정을 확정해 넘기면 팹리스가 그에 맞춰 설계하는 분업 구조였다. 이제는 케이던스 같은 EDA 기업까지 공정 초기부터 참여해 칩 크기, 열 배출 경로, 전력 구성을 함께 설계한다.
또 하나의 해법은 첨단 패키징이다. 거대한 칩을 하나로 만드는 대신 기능별 칩렛을 나눠 만들고, 이를 실리콘으로 만든 미세 연결 구조 위에 정교하게 이어 붙인다. 영상은 TSMC의 CoWoS 같은 기술을 예로 들며 연산 칩과 HBM을 가깝게 배치해 데이터를 빠르게 주고받는다고 설명한다. 이제 AI 시스템의 성능은 트랜지스터 선폭보다, 여러 칩을 열 문제 없이 하나의 덩어리로 묶는 패키징 능력에 좌우된다는 것이다.
⏱ 16:567. 삼성의 전략과 결론
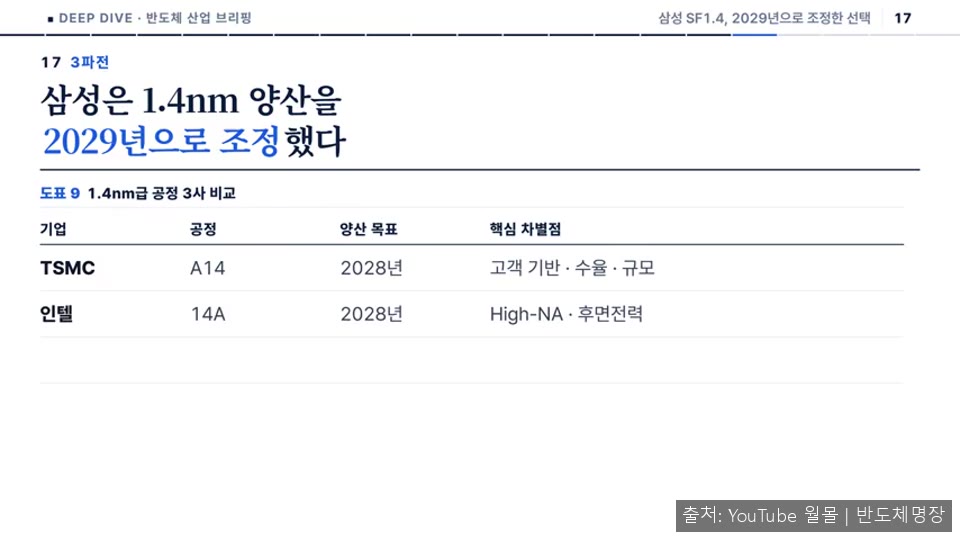
⏱ 16:56삼성전자는 1.4나노급 SF1.4의 양산 목표를 2029년으로 잡았고, 현재는 2나노 GAA 공정의 수율 안정화에 집중하고 있다고 소개된다. 노드 숫자만 보면 뒤처진 듯하지만, 영상은 먼저 명명하기보다 AI 칩 고객에게 수율과 안정성으로 신뢰를 얻으려는 판단으로 해석한다.
삼성은 초미세 파운드리, 차세대 HBM 생산, 첨단 패키징을 한 울타리에 모두 갖춘 턴키 생태계라는 강점이 있다. 로직, HBM, 패키징 팀이 한자리에서 설계와 열 관리를 실시간으로 조율할 수 있다는 것이다.
결론적으로 몇 나노라는 숫자 경쟁보다 고객 확보 능력, S램 병목 극복, 로직과 HBM의 패키징 융합이 승부를 가른다는 것이다. 2028년 이후 기업 발표를 볼 때는 누가 먼저 공정을 시작했는지보다, 설계 IP 파트너 확보와 패키징의 수율 및 생산능력 증가를 보라고 권한다.