요약
⏱ 00:001. HBM이 주목받는 배경
⏱ 00:00AI 시대가 본격화되면서 메모리 반도체 산업에도 큰 변화가 왔다는 문제의식으로 영상이 시작합니다. HBM(고대역폭 메모리)이 국내 반도체 산업에 새로운 기회로 떠올랐다는 점을 짚고, HBM이 무엇인지 기본부터 차근차근 풀어가겠다고 예고합니다.
⏱ 03:252. 대역폭을 도로 폭에 비유하기
⏱ 03:25데이터 통신에서 대역폭은 단위 시간에 주고받을 수 있는 정보량을 뜻합니다. 송신부와 수신부 사이의 입출력(I/O) 경로를 여러 개 동시에 쓸수록 한 번에 많은 0과 1을 보낼 수 있으므로, 경로가 수백 개, 천 개를 넘으면 전달량이 크게 늘어납니다.
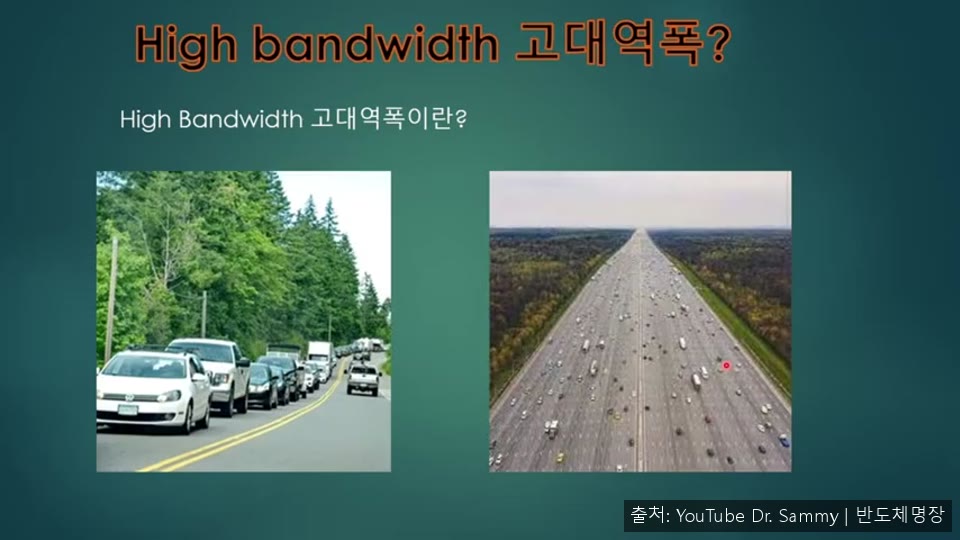
이를 교통에 빗대면 대역폭은 도로의 폭과 같고, 차선이 많을수록 단위 시간당 더 많은 차량, 즉 데이터를 빠르게 보낼 수 있다는 설명입니다.
⏱ 05:563. GDDR6와 HBM의 수치 비교
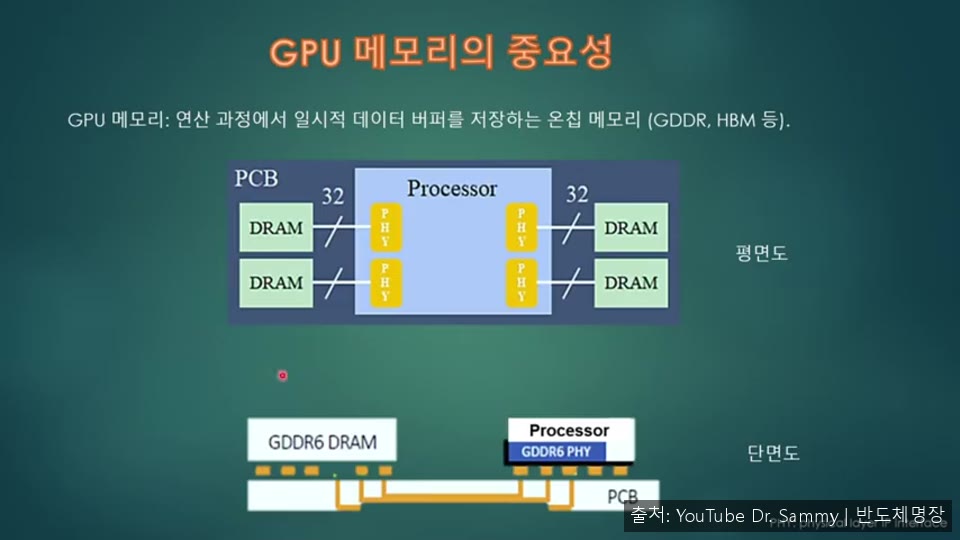
⏱ 05:56GPU 주변에 메모리를 붙이는 대표 방식인 GDDR6를 예로 듭니다. 칩 12개가 GPU를 둘러싸고, 칩당 2GB 용량에 I/O 핀이 32개씩이라 총 384핀입니다. 핀당 속도 16Gbps는 바이트로 환산하면 2GB/s이고, 전체 대역폭은 이론상 약 768GB/s라고 계산합니다.
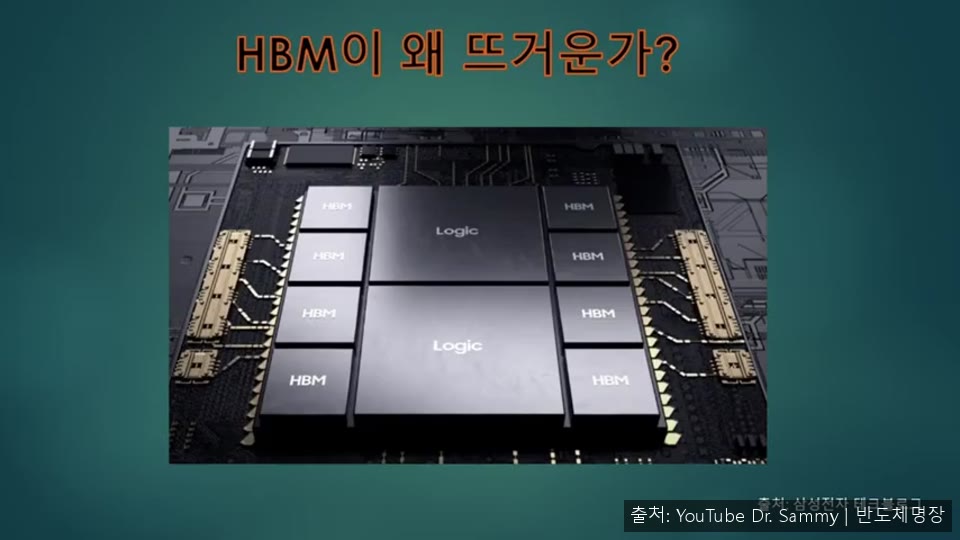
HBM3는 GPU 주변에 4개 스택이 놓이고 스택당 24GB, 총 96GB입니다. 핀당 속도는 0.8GB/s로 GDDR6보다 낮지만, 스택당 I/O 핀이 1024개라 총 4096개가 동시에 작동해 대역폭이 약 3.2TB/s에 이릅니다. 속도가 느려도 통로가 훨씬 넓어 전체 처리량이 크게 앞선다는 것이 핵심입니다.
영상은 HBM 하부에 약 1800~2000개의 범프가 있지만 실제 데이터 핀은 1024개이고, 나머지는 전원, 접지, 명령, 클럭 등에 쓰인다고 설명합니다.
⏱ 14:004. 엔비디아 AI 가속기의 세대별 흐름
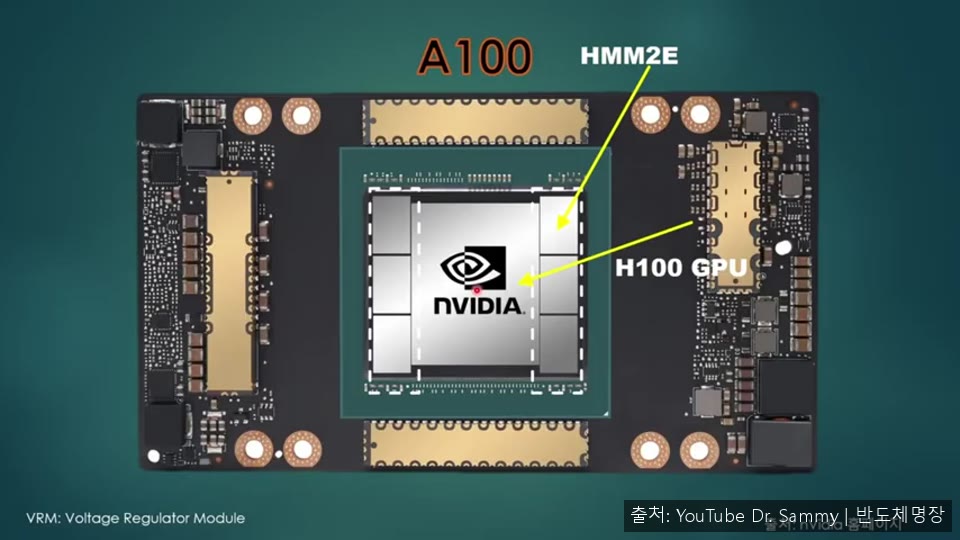
⏱ 14:00엔비디아 GPU 가속기의 계보를 훑습니다. 2020년 출시된 암페어(Ampere)는 HBM을 여섯 개 탑재했고 메모리 용량은 40GB 또는 80GB, 대역폭은 약 2TB/s였습니다. 2022년 출시된 호퍼(Hopper)는 HBM3를 적용해 용량 80GB, 대역폭 약 3.35TB/s로 향상됐고, 확장판 H200은 대역폭이 4.8TB/s로 늘었습니다.
⏱ 18:045. GPU와 메모리의 역할, 메모리 3요소
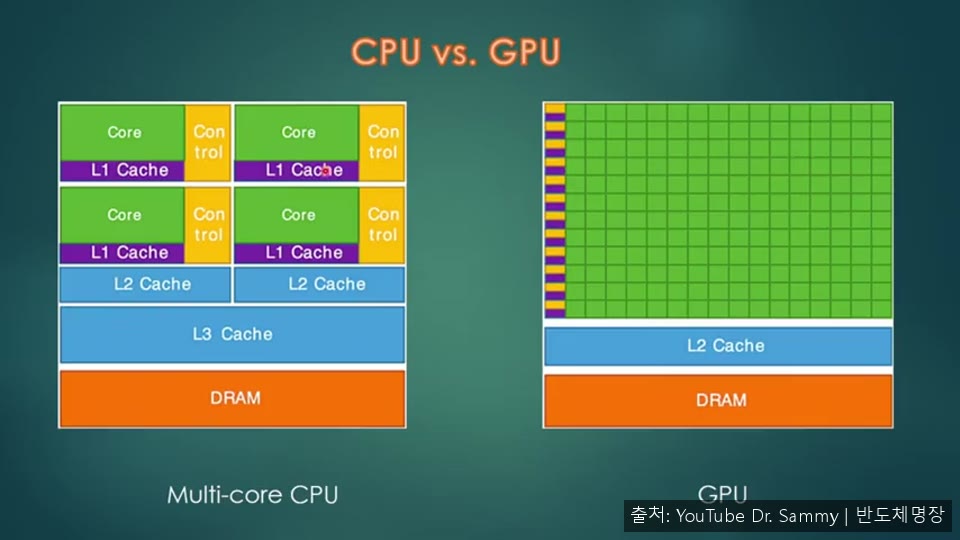
⏱ 18:04GPU는 그래픽 렌더링과 병렬 수학 연산에 특화된 프로세서로, 많은 코어가 동시에 대량의 데이터를 처리하므로 높은 메모리 대역폭에 크게 의존합니다. 메모리의 핵심 특성은 대역폭, 반응 속도(레이턴시), 용량 세 가지로 정리됩니다.
영상은 이를 공장과 창고에 비유합니다. 중간 반제품을 창고에 넣고 꺼내는 운송에서 대역폭은 단위 시간에 오가는 화물 총량이고, 레이턴시는 요청 후 개별 트럭이 도착하기까지 걸리는 시간, 용량은 창고에 실을 수 있는 총 적재량에 해당합니다. 세 가지 중 하나라도 부족하면 병목과 지연이 생겨 AI 학습이나 3D 렌더링 같은 고대역폭 작업의 성능이 떨어집니다.
⏱ 24:126. 적층 구조와 TSV
⏱ 24:12GDDR은 메모리 칩을 기판 위에 평면으로 배치하고 칩마다 32개 핀으로 GPU와 병렬 연결하기 때문에 도로 폭이 좁다는 한계가 있습니다. HBM은 DRAM 여러 층을 수직으로 쌓아 같은 면적에서 훨씬 큰 용량을 확보합니다. 예를 들어 칩 하나가 4GB라면 네 층을 쌓아 16GB가 됩니다.
층간 연결에는 TSV(Through Silicon Via, 실리콘 관통 전극)가 쓰입니다. 칩을 관통하는 전극으로 각 층을 잇기 때문에, 원래 1차선이던 통로가 4층 적층 시 4차선처럼 늘어나는 효과가 있습니다. 적층하면 발열과 동작 속도 문제가 생길 수 있지만, 실질적인 데이터 처리량인 대역폭이 더 중요하며 그 측면에서 HBM이 탁월하다고 강조합니다.
⏱ 29:007. 2.5D 패키징, CoWoS와 인터포저
⏱ 29:00HBM은 GPU와 함께 실리콘 인터포저(interposer) 위에 올려 하나의 패키지로 만드는데, 이 방식이 TSMC의 CoWoS(Chip on Wafer on Substrate)입니다. 인터포저는 칩과 PCB 사이에 놓인 중간 실리콘 기판으로, HBM과 로직칩의 촘촘한 범프 간격을 PCB가 감당하지 못하기 때문에 필요합니다. 영상은 이 밀도 차이가 거의 20배에 이른다고 설명합니다.
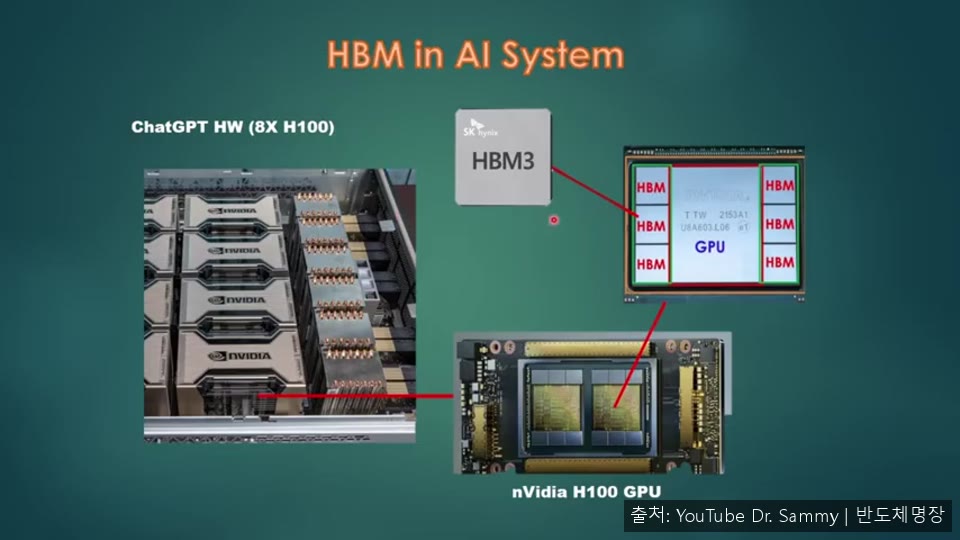
칩이 수평으로 나란히 배치되고 HBM은 수직으로 적층되어 있어 2D와 3D의 중간이라는 뜻에서 2.5D 패키징이라 부릅니다. 영상은 HBM 기술의 핵심이 메모리 셀 자체보다 적층 방법과 칩을 수직으로 잇는 인터코넥트, 즉 패키징 기술에 있다고 정리합니다. 아울러 웨이퍼 공정 후 잘라낸 다이(die)와 칩(chip)의 용어 차이, 웨이퍼 단계의 EDS 테스트와 패키지 후 테스트로 양품을 고르는 흐름도 짚습니다.