요약
⏱ 00:001. 실험 목적과 하드웨어 구성
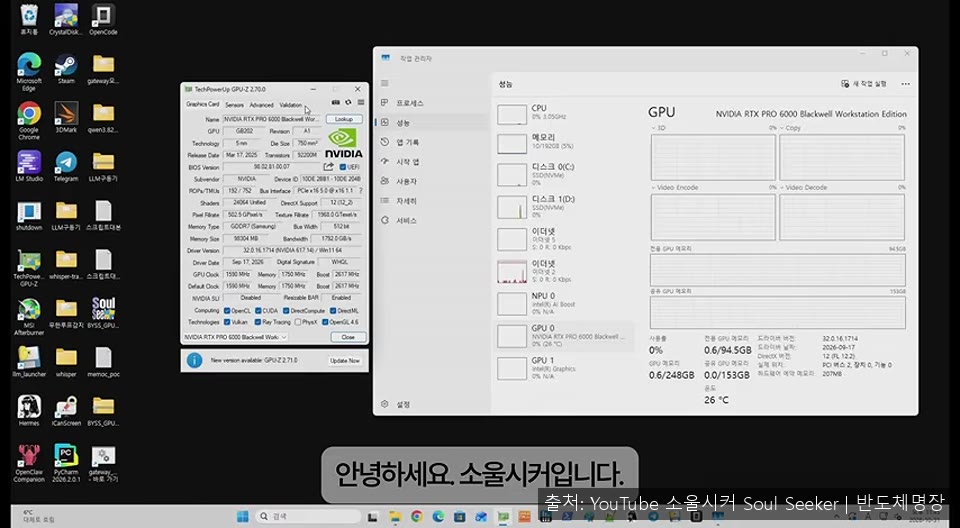
⏱ 00:00발표자는 RTX PRO 6000 Blackwell 워크스테이션 에디션을 장착해 96GB GDDR7 VRAM 환경을 구성했다. 시스템 메모리는 192GB이며, 메모리는 6000 XMP/EXPO 프로파일(CL26-35-35)로 맞췄다. 핵심 질문은 이전 영상에서 RTX 5090 한 장으로 돌렸던 대형 모델에서, VRAM 용량 차이가 토큰 속도를 얼마나 바꾸는지였다.
⏱ 03:002. 테스트 모델과 혼합 가중치 양자화
⏱ 03:00테스트 대상은 Qwen 3.8 Flash Next 8비트 양자화 모델, GLM 5.3 Flash의 Project Maya 혼합 가중치 버전(Maya L), DeepSeek V4.1 Flash 기반 혼합 가중치 모델(XQ V4)의 세 가지다. 혼합 가중치는 중요한 부분은 높은 정밀도를 유지하고 덜 중요한 부분은 낮춰 전체 용량을 줄이는 방식이다. 발표자는 이름에 적힌 비트 수만으로는 실제 정밀도를 단정하기 어렵다고 설명했다.
DeepSeek 모델은 이전 XQ V3 버전에서 지능 저하 이슈가 확인되어 V4로 교체했다고 한다. 두 버전의 용량은 같다고 밝혔다. 세 모델 모두 컨텍스트 길이는 100만 토큰으로 설정했다.
⏱ 04:423. 벤치마크 결과와 가상 메모리 조정
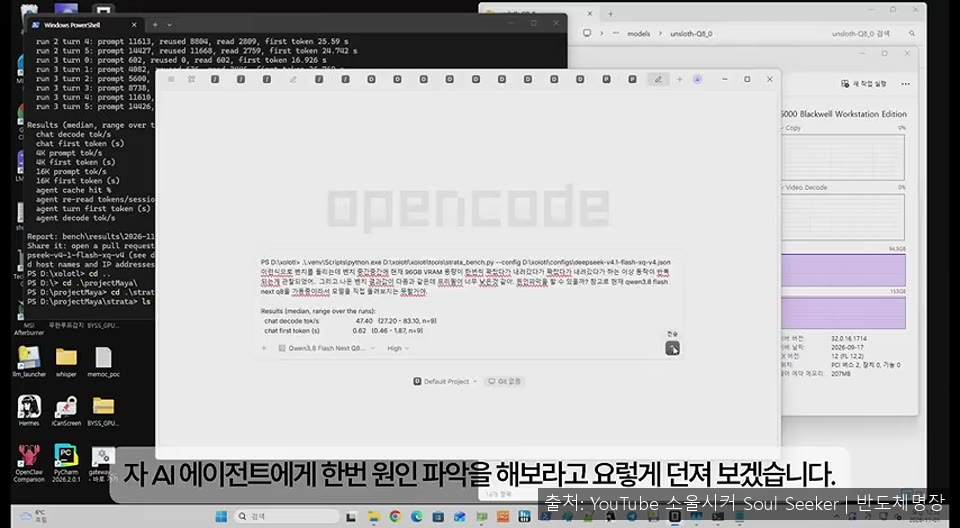
⏱ 04:42처음 벤치에서 Qwen 모델은 VRAM을 약 37GB만 사용했고, 디코딩은 약 60 토큰/초, 프리필은 약 1900 수준이었다. 발표자는 RTX 5090에서 얻은 약 50 토큰/초와 비교해 차이가 작다고 보고, AI 에이전트에 레시피와 하드웨어 정보를 넣어 원인을 분석하게 했다.

⏱ 11:304. GLM 5.3 Flash Maya L 결과
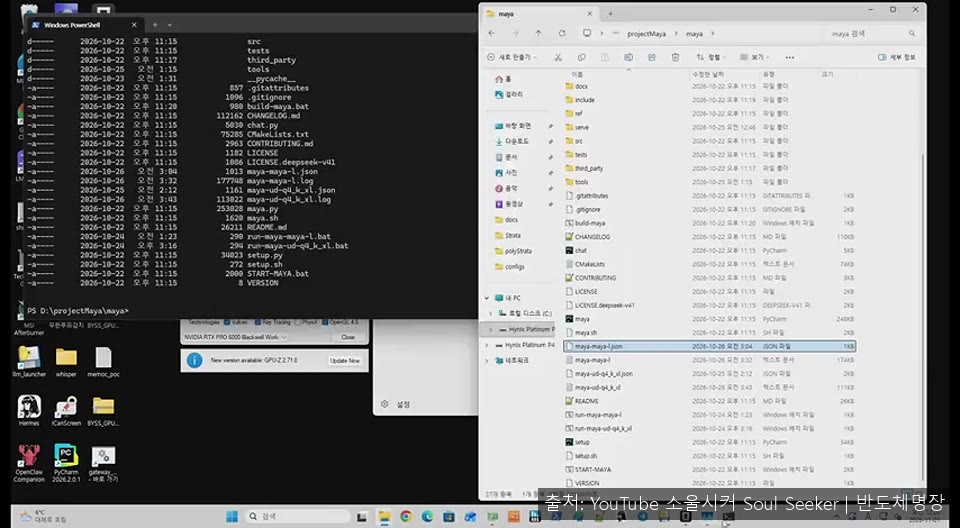
⏱ 11:30같은 벤치 방식으로 GLM 5.3 Flash Maya L을 돌리자 VRAM은 충분히 사용되었고 시스템 메모리 사용은 약 90GB 수준이었다. 디코딩은 약 50 토큰/초, 프리필은 약 3000 수준으로 나왔다. 발표자는 RTX 5090에서 20 토큰/초 미만이었던 이전 결과와 비교해 크게 개선되었다고 설명했다.
⏱ 14:275. DeepSeek V4.1 Flash 벤치마크
⏱ 14:27DeepSeek 모델은 풀 정밀도 기준으로 512GB 정도의 메모리가 필요하다고 소개되었다. 발표자는 혼합 가중치 버전을 100만 토큰 컨텍스트로 구동했다. 실행 중 VRAM은 약 94GB 사이에서 오르내렸고, 시스템 메모리는 128GB를 조금 넘게 사용했다. 디코딩은 약 47 토큰/초였지만 프리필이 다른 두 모델보다 현저히 느려 대기 시간이 길었다.

⏱ 17:006. 동일 프롬프트 게임 생성 비교
⏱ 17:00같은 프롬프트로 세 모델에게 게임 개발을 시킨 뒤 결과물을 비교했다. Qwen 결과물은 완성도가 높고 버그가 두드러지지 않았다. GLM 결과물은 체력이 많은 적이 등장해 쉽게 처리되지 않는 특징이 있었다. DeepSeek 결과물은 GLM과 구성이 비슷했지만 블랙홀 같은 요소의 난이도가 높게 느껴졌다. 발표자는 게임 테스트만으로 모델의 우열을 가리기는 어렵다고 결론지었다.