요약
같은 192GB 메모리를 XMP 설정과 순정 설정으로 나눠 Strata 기반 LLM을 돌려본 실험이다. Qwen 계열은 디코딩보다 프리필에서 차이가 컸고, 활성 전문가 규모가 큰 GLM 계열은 디코딩 손실이 두드러졌다. 고클럭 구성은 안정성 검증이 필수이며 메모리 칩 종류에 따라 가능한 클럭 폭이 크게 달라진다고 정리했다.
⏱ 00:001. 테스트 배경과 가설
⏱ 00:00이전 영상에서 RTX PRO 6000과 Strata로 측정할 때는 6000 CL26 계열 XMP가 적용된 상태였다. 이번에는 이 메모리 설정이 Strata의 추론 성능에 얼마나 영향을 주는지 확인하려고 한다. 일반적인 엔진은 모델을 VRAM에 모두 올리면 메모리 클럭과 거의 무관하지만, Strata는 전문가 그룹 데이터를 실시간으로 시스템 메모리에서 VRAM으로 가져오기 때문에 대역폭 영향이 있을 것이라는 가설을 세웠다.
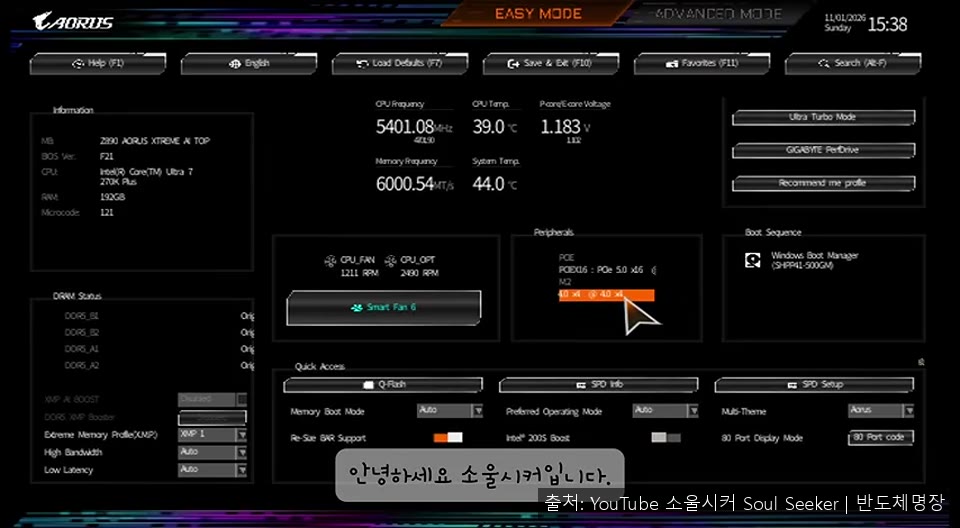
이 메모리는 일반 XMP 제품이 아니라 고수율로 선별된 칩이라는 점도 전제로 깔고 있다.
⏱ 00:522. 순정 설정과 Poly Strata 벤치
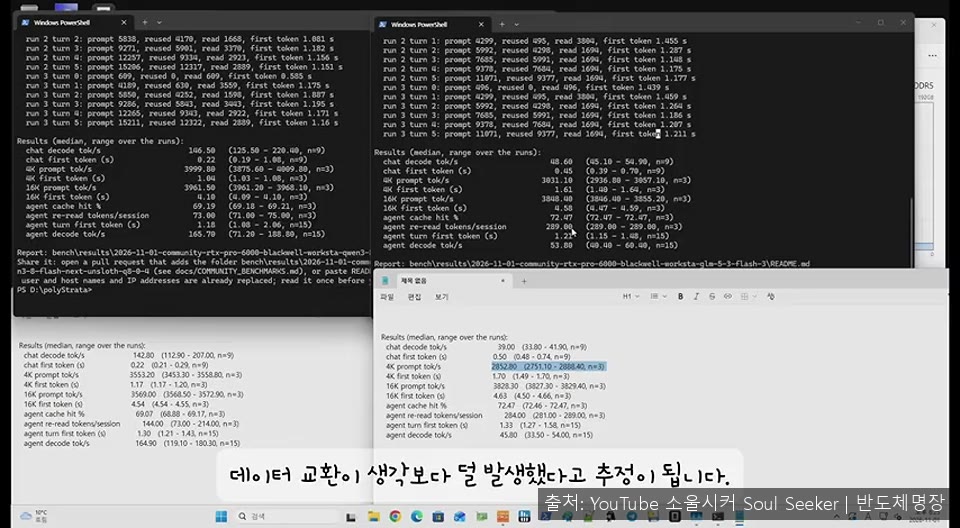
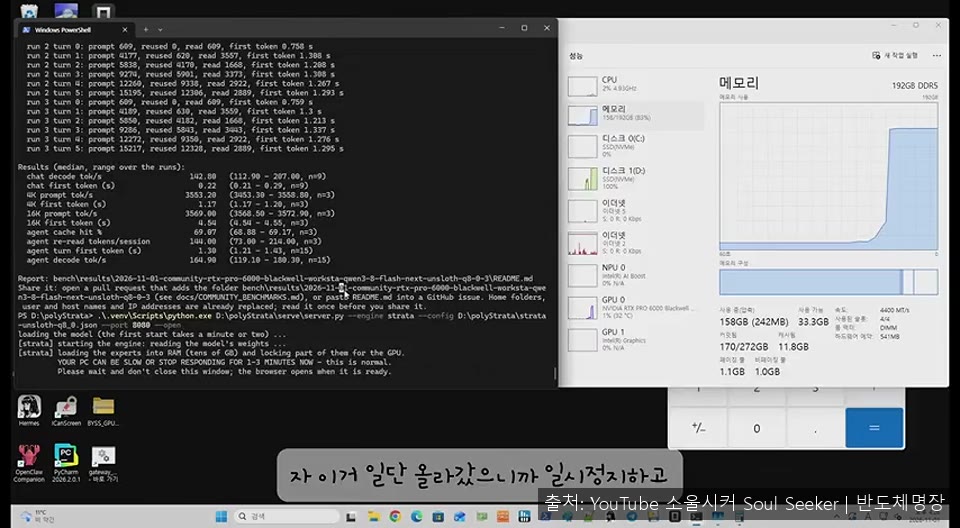
⏱ 00:52메모리를 초기화하고 순정 상태로 부팅하니 클럭이 2200(두 배인 4400으로 표시)으로 나왔다. 타이밍은 클럭을 낮춘 만큼 조여지지 않은 순정 값이라 기대보다 느슨했다. 이 상태에서 Poly Strata의 Qwen 계열 Flash Next 8비트 모델을 돌리니 디코딩은 약 142.8 토큰, 프리필은 약 3553 토큰이 나왔다. XMP 결과와 비교하면 디코딩은 약 7토큰, 4.8% 정도 줄었다.
⏱ 06:073. Xolotl 엔진 비교와 GLM 순정 결과
⏱ 06:07Poly Strata에서 VRAM을 거의 160GB까지 쓰던 Qwen 모델이 Xolotl에서는 DRAM 사용량이 100GB 아래로 보여, 메모리를 아낄 수 있을 것으로 기대했다. 그러나 Xolotl에서 돌린 결과는 디코딩과 프리필이 모두 크게 낮아 비교 기준으로 쓰기 어렵다고 판단되어 폐기했다.
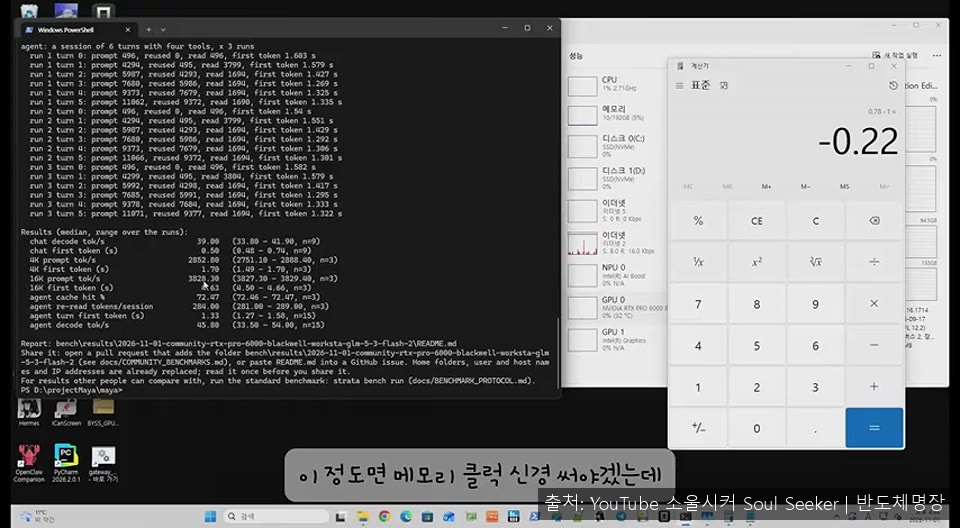
같은 조건에서 GLM 5.3 Flash 모델은 Project Maya에서 실행했다. 디코딩은 약 50 토큰 수준이 나왔고 XMP 결과보다 약 22% 낮았다. 프리필은 상대적으로 덜 떨어졌지만 디코딩 감소폭이 커서 메모리 영향이 생각보다 크다고 결론지었다.
⏱ 08:094. 고클럭 튜닝 과정과 안정성 주의
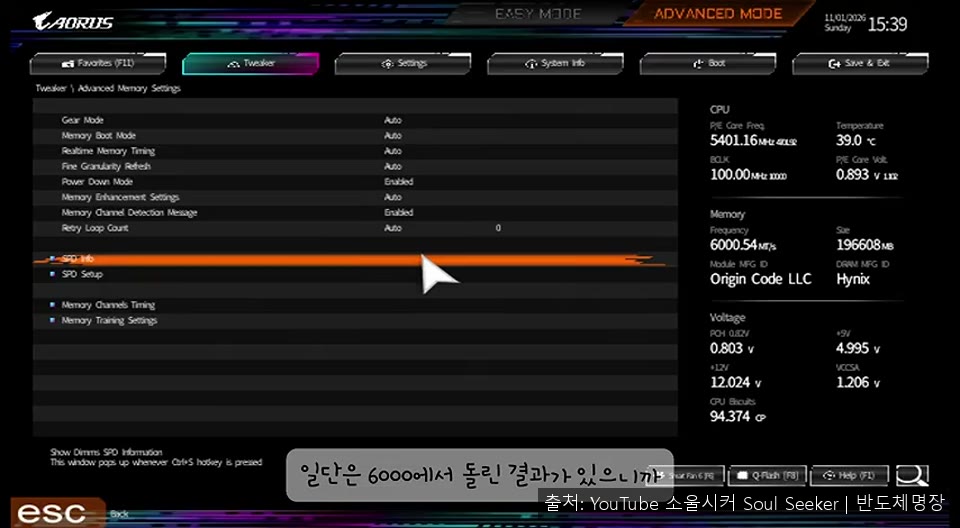
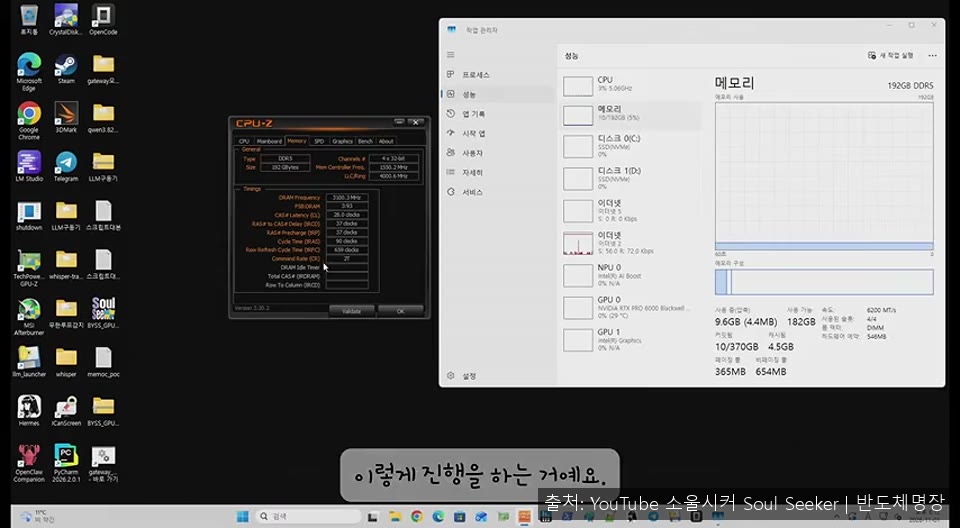
⏱ 08:09BIOS에서 전압을 1.45V로 올리고 기어 모드와 부팅 옵션을 조정한 뒤 클럭을 단계적으로 올렸다. 6000, 6200, 6400까지는 부팅에 성공했지만 6400은 부팅 시간이 길어지며 한계에 가까워졌고, 6600은 실패했다. 이에 6200으로 내리고 CL을 28, RCD와 RP를 37 수준으로 풀어 대역폭을 우선하는 조합을 택했다.
발표자는 이 설정이 안정성 테스트를 거치지 않은 상태라고 분명히 밝혔다. 메모리 튜닝은 데이터 오류로 이어질 수 있고, 192GB 용량의 안정성 테스트는 하루 종일 걸릴 수 있다는 점을 강조했다. 또한 이번 칩은 고수율 선별품이라 일반 하이닉스 메모리에서는 같은 결과가 나오지 않을 가능성이 높다고 덧붙였다.
⏱ 13:545. 튜닝 후 벤치 결과와 모델별 차이
⏱ 13:54튜닝 후 Qwen 계열 모델의 디코딩은 약 146.5 토큰으로, 순정 대비 3% 정도 차이에 그쳤다. 프리필은 약 4000 수준으로 순정 3553보다 10% 넘게 높아, 이 모델에서는 프리필 쪽에서 대역폭 효과가 확인됐다.
GLM 5.3 Flash는 튜닝 후 디코딩 차이가 약 9토큰으로 나타났다. 전체 토큰 수가 50 안팎인 점을 감안하면 약 20%에 가까운 차이다. 프리필은 4K 프롬프트에서 약 200토큰 차이가 났고 16K 프롬프트에서는 거의 차이가 없었다.
발표자는 Qwen은 활성 파라미터가 작아 전문가를 교체할 때 메모리 왕복 병목이 생기고, GLM은 활성 전문가 규모가 커서 디코딩에서 대역폭 영향이 크게 나타난다고 추정했다.
⏱ 18:006. 칩 선택과 추가 비용 판단
⏱ 18:00메모리 칩 종류에 따른 차이도 짚었다. 하이닉스 칩으로 풀뱅크 192GB를 구성하면 6200 이상도 부팅이 가능했지만, 마이크론 칩은 4600에서 5000 사이에서 부팅 한계를 보여 순정에 가깝게 써야 한다는 것이다. 데스크톱용 고용량 UDIMM 칩은 서버 쪽 수요로 공급이 어려워 가격이 크게 올랐다고 언급했다.