요약
⏱ 00:001. 웨이퍼 기반 AI 칩의 등장 배경
⏱ 00:00영상은 Cerebras의 CS-4 시스템을 소개하며, 제조사 주장대로 엔비디아 GPU보다 AI 답변 생성 속도를 최대 30배 높일 수 있는지 살펴봅니다. 제조사 자체 테스트에서는 단일 사용자 기준 초당 4,400개 이상의 토큰을 생성했다는 수치가 제시됩니다.
⏱ 01:312. 웨이퍼 스케일 엔진의 구조
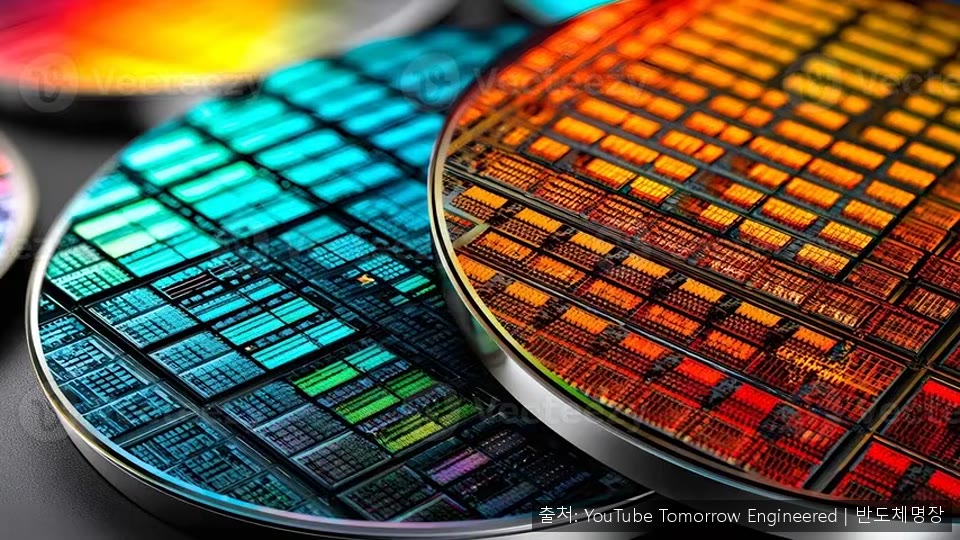
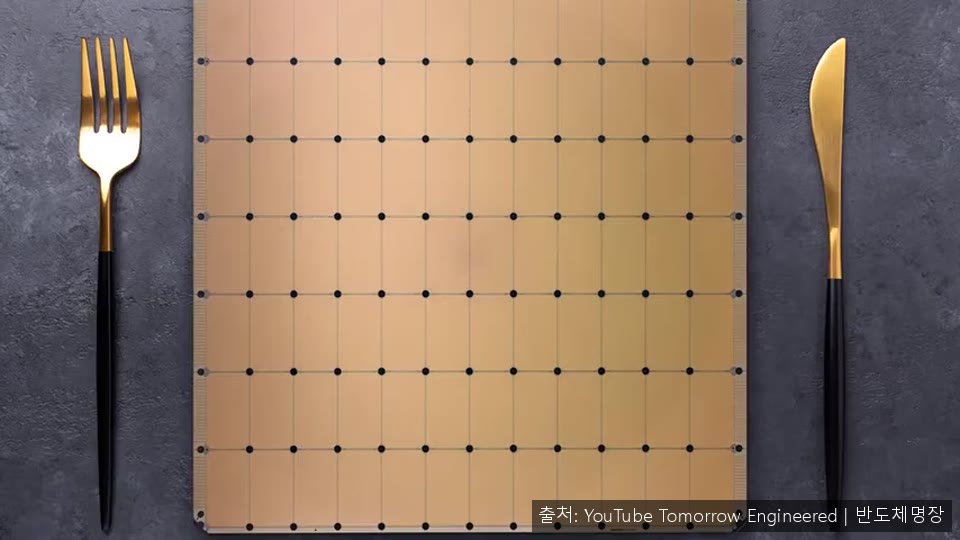
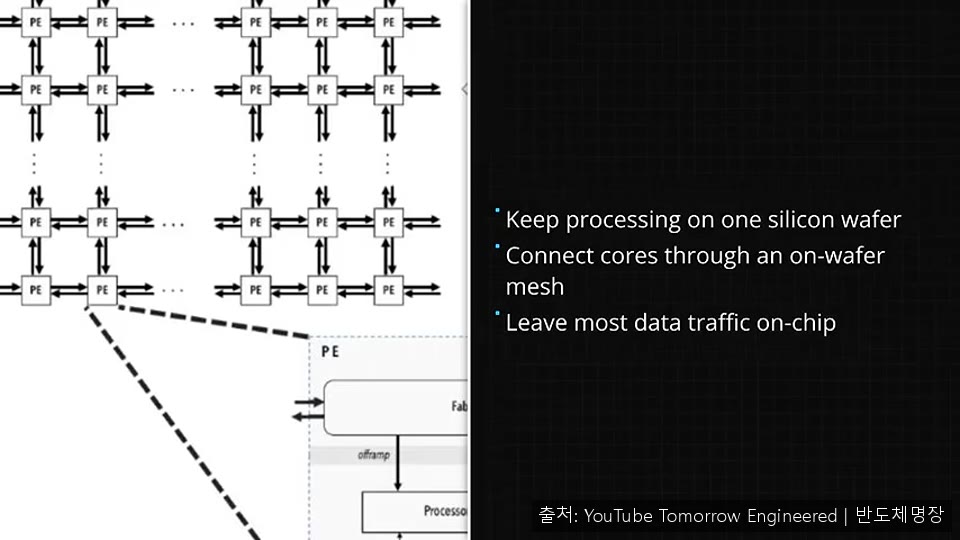
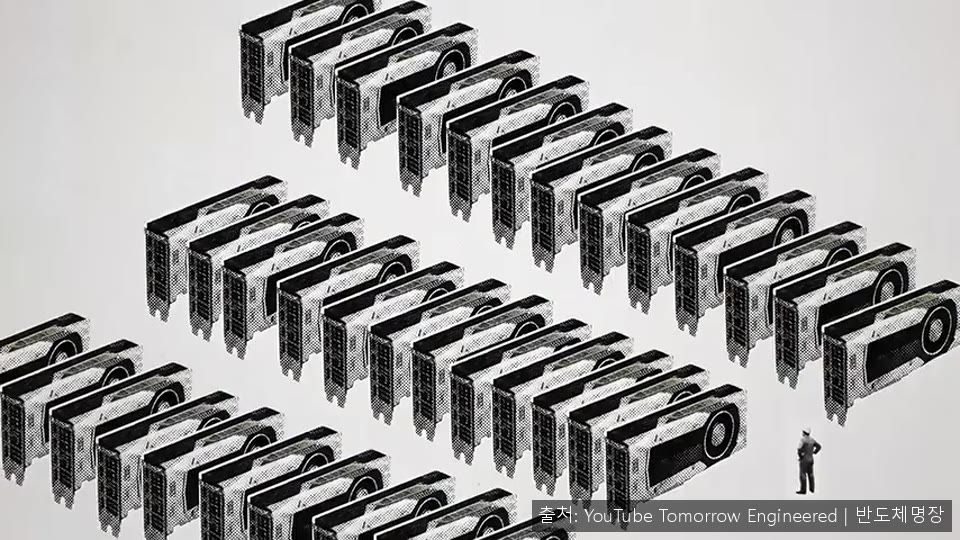
⏱ 01:31일반 칩은 지름 300mm 웨이퍼를 여러 개의 개별 칩으로 잘라 쓰지만, Cerebras는 웨이퍼를 한 변 21.5cm 정사각형으로 다듬어 거의 전체를 하나의 프로세서로 만듭니다. 이 칩은 H100보다 실리콘 면적이 약 57배 크고, 4조 개의 트랜지스터를 담고 있습니다.
⏱ 02:493. 결함 우회와 열, 전력 과제
⏱ 02:49웨이퍼 전체를 하나의 칩으로 쓰면 무작위 결함 하나가 전체를 망칠 수 있습니다. Cerebras는 약 90만 개의 코어에 약 1%의 예비 코어를 두고, 공장 테스트에서 고장 난 코어를 찾으면 예비 코어를 활성화해 회로에서 제외하는 방식으로 이 문제를 풀었습니다.
⏱ 04:334. 추론에서 메모리가 병목이 되는 이유
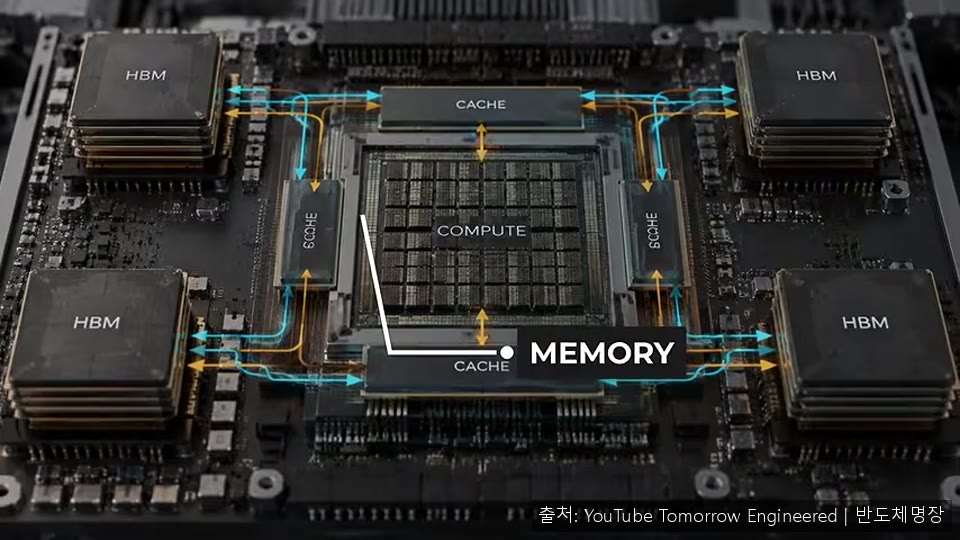
⏱ 04:33AI 추론은 프롬프트를 한 번에 읽는 단계와 토큰을 하나씩 생성하는 단계로 나뉩니다. 앞 단계는 GPU가 잘 처리하지만, 뒤 생성 단계에서는 토큰마다 수십억 개의 모델 가중치를 메모리에서 코어로 가져와야 합니다.
⏱ 06:595. 독립 검증과 실제 성능 차이
⏱ 06:592025년 5월 독립 벤치마크 기업 Artificial Analysis는 Meta의 Llama 4 Maverick 모델에서 Cerebras가 초당 2,500개 이상의 토큰을 기록했다고 발표했습니다. 같은 모델에서 엔비디아가 발표한 Blackwell 수치 약 1,000개보다 높은 결과였습니다.
다만 CS-4의 외부 실사용 테스트 결과는 아직 공개되지 않았습니다. 반도체 분석기관 SemiAnalysis는 자체 추정으로 서버 처리량을 고려하면 Blackwell 대비 사용자당 속도가 약 20~40배 빠르다고 보았고, 30배는 타당한 수치로 평가했습니다. 이 차이는 웨이퍼의 연산 능력이 메모리 대역폭을 모두 활용하지 못하고, 대형 모델이 여러 웨이퍼에 나뉘어 웨이퍼 간 데이터 전달 시간이 생기기 때문으로 설명됩니다.
⏱ 12:426. CS-4의 개선점과 설계 변화
⏱ 12:42CS-4는 새 칩이 아니라 기존 5nm WSE-3를 더 높은 출력으로 구동하는 방식으로 개선되었습니다. 전력 변환 장치를 웨이퍼에 가깝게 배치해 에너지 손실을 줄이고 공급 전력을 두 배로 높였으며, 직접 액체 냉각을 더해 클럭이 약 1.4GHz에서 2.8GHz 수준으로 올랐다는 외부 추정이 있습니다.
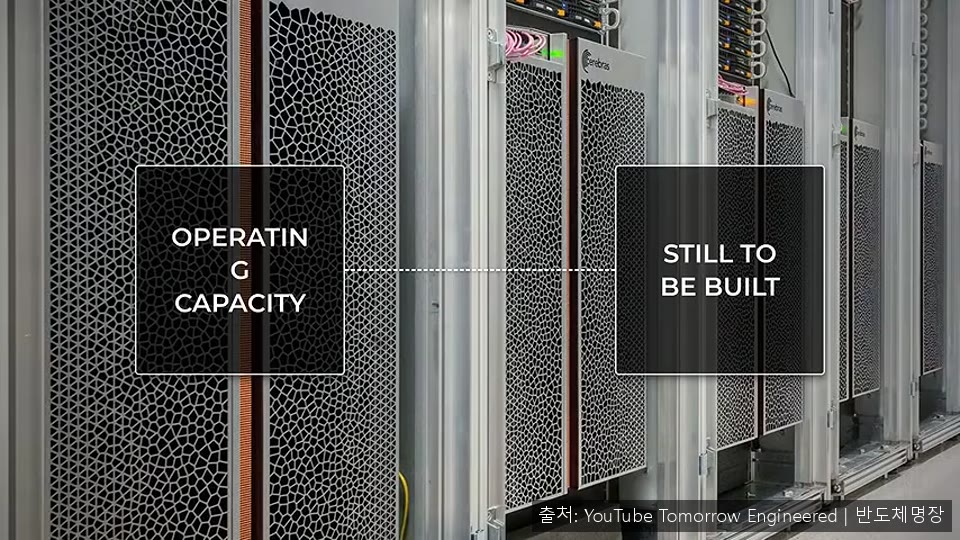
랙 구조도 바뀌었습니다. 웨이퍼는 독립형 백팩 모듈로 수직 장착되고, 한 랙에 3개의 웨이퍼가 들어갑니다. 웨이퍼 간 데이터 이동 시간은 5마이크로초에서 2마이크로초로 줄었다고 합니다. 자체 테스트에서는 120B 규모 오픈 모델에서 사용자당 초당 4,400토큰 이상을 기록했으며, 이는 이전 시스템의 약 두 배입니다.
⏱ 17:267. 메모리 용량과 확장의 한계
⏱ 17:26속도는 빨라졌지만 웨이퍼당 메모리 용량은 2021년 WSE-2 이후 거의 바뀌지 않은 44GB에 머물러 있습니다. 이 때문에 가장 큰 모델이나 긴 문맥을 다루려면 여러 웨이퍼에 분산해야 하고, 실행 기록이 늘어날수록 비용이 급격히 커집니다.
분석에 따르면 1.6조 개 매개변수의 DeepSeek V4 Pro를 100만 토큰 문맥으로 서비스하려면 약 40대의 CS-4가 필요하고, 답변을 하나도 생성하기 전에 2천만 달러 이상의 하드웨어와 1메가와트의 전력이 필요합니다. Cerebras는 AMD 헬리오스 랙이나 아마존 트레이니엄 칩과 결합하는 혼합형 구성을 제시하지만, 프롬프트 처리 장비와 답변 생성 장비의 비율이 구매 시점에 고정된다는 점이 부담으로 지적됩니다. 한편 엔비디아는 추론 칩 기술 확보를 위해 Groq의 기술 라이선스에 약 200억 달러를 지불한 것으로 전해집니다.