요약
⏱ 00:001. 엣지 AI 인프라 기업 지향
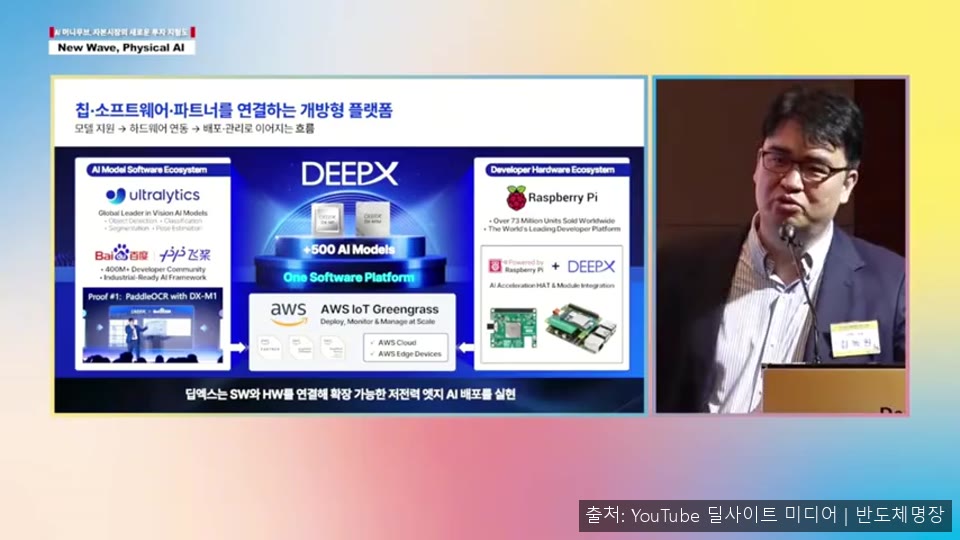
⏱ 00:00딥엑스는 자신들을 칩 판매 기업이 아니라 피지컬 AI 인프라 기업으로 규정한다. 발표자는 해외 소프트웨어 알고리즘 생태계의 기본 옵션으로 자사 기술이 채택됐다고 설명하며, 전 세계 수백만 명의 개발자가 쓰는 오픈소스 AI 모델과 주요 하드웨어 플랫폼을 지원한다고 주장한다.
또한 대학 컴퓨터구조 수업의 교재 수준으로 교육 생태계에도 진입했다고 덧붙인다. 요지는 개방형 생태계에서 필수 요소를 모두 갖춘 첫 번째 AI 프로바이더라는 것이다.
⏱ 01:012. CUDA 호환 전략
⏱ 01:01딥엑스는 엔비디아 CUDA와의 호환을 선언한 첫 번째 글로벌 NPU 회사라고 밝힌다. 로봇 개발용 소프트웨어 프레임워크와 라이브러리를 제공해 로봇의 기반 AI 동작을 미리 준비해 두고, 개발자가 이를 조합해 자신의 로봇을 만들 수 있게 한다는 구상이다.
명령어 체계가 기본적으로 같고 일부 명령어 차이만 변환하면 된다는 것이 발표의 논리다. 따라서 라이브러리 이름과 칩만 바꾸면 기존과 같은 AI 동작이 일어난다고 설명한다.
⏱ 02:323. 저전력과 가격 경쟁력
⏱ 02:32회사는 같은 작업을 훨씬 적은 전력으로 처리해 배터리 사용 시간을 크게 늘릴 수 있다고 주장한다. 고성능 GPU 대비 칩 가격 차이가 커서 고객 입장에서 마진 측면의 장점이 있고, 이것이 기존 시스템의 교체 수요를 만든다고 본다.

다만 구체적인 수치는 발표 내 주장으로만 제시되었으며 검증된 자료는 아니다. 실제 채택 여부는 고객의 파일럿 테스트 결과에 달려 있다고 덧붙인다.
⏱ 04:004. 데이터센터 병목 현실
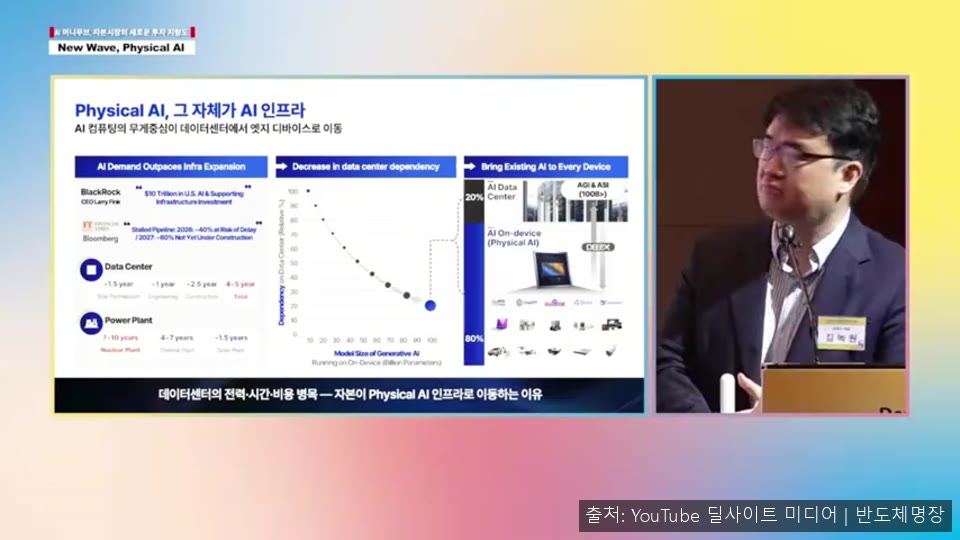
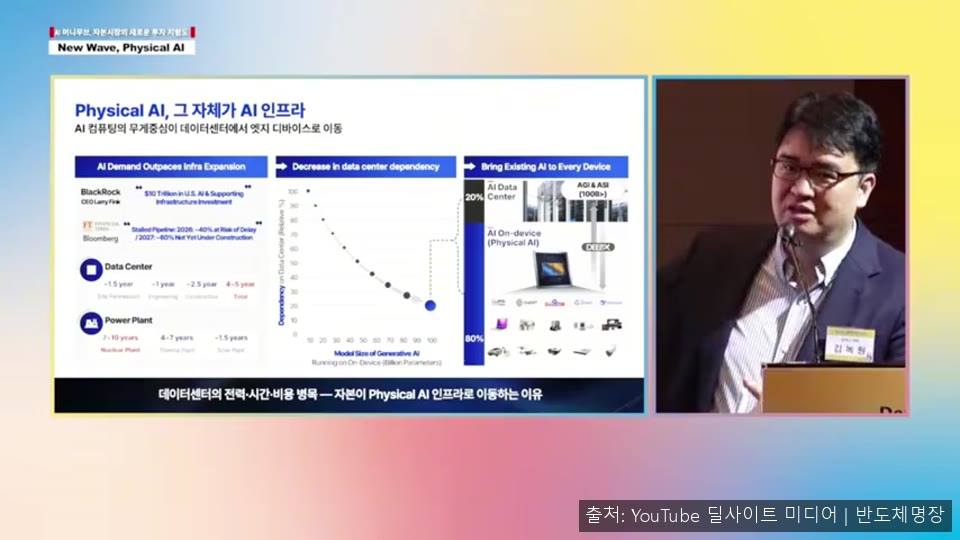
⏱ 04:00발표자는 AI 인프라 투자 확대 전망과 달리 데이터센터 건설이 지연되는 현실을 언급한다. 착공부터 완공까지 여러 해가 걸리고, 전력 설비 같은 발전 인프라도 긴 리드타임이 필요해 자금만으로는 해결하기 어렵다는 것이다.
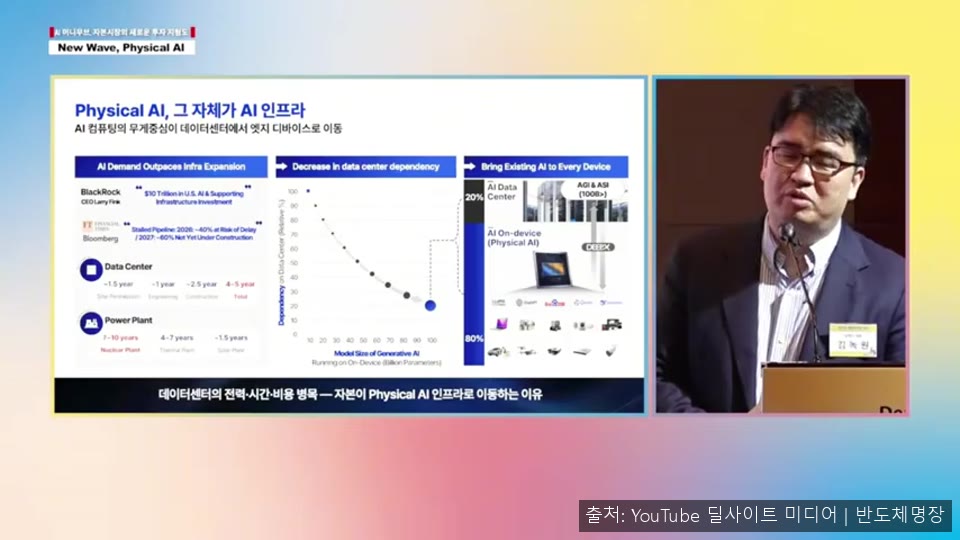
이와 관련해 대형 클라우드 기업 재무 책임자와 나눈 대화를 인용하며, 자금이 있어도 설비를 짓지 못하는 것이 업계의 실제 상황이라고 설명한다.
⏱ 06:015. 온디바이스 대형 모델 전략
⏱ 06:01회사는 약 100B급(약 1000억 파라미터) 모델을 기기 안에 넣을 수 있다면 현재 AI 트래픽의 상당 부분을 데이터센터 없이 처리할 수 있다고 본다. 80% 이상이라는 주장도 제시했다. 데이터센터를 계속 늘리는 대신 모델을 기기로 옮기는 접근이 핵심 아이디어라는 것이다.
발표자는 초기 검색 엔진이 새로운 계산 방식으로 시장을 재편한 사례에 비유하며, 이 방식이 큰 가치를 가질 수 있다고 강조한다.
⏱ 07:006. 2세대 칩 사양 목표
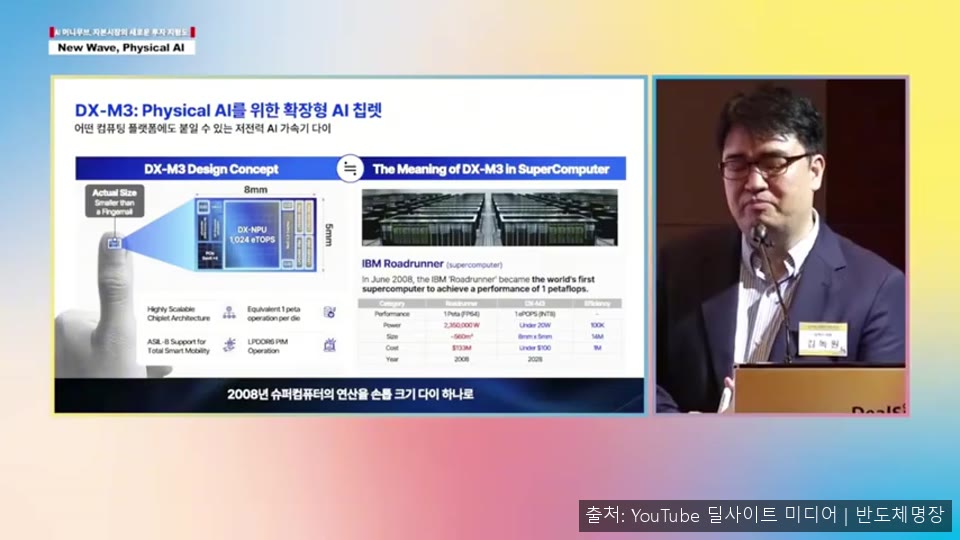
⏱ 07:002세대 제품은 삼성 파운드리의 2나노 공정으로 생산되며, 이번 달 공정 진입 후 내년 3월께 첫 샘플을 받는 일정이라고 밝힌다. 목표는 Llama 계열 100B 모델 구동, 10 TOPS 이상의 처리 성능(초당 10토큰 이상 생성 수준), 5W 미만 전력이다.
가격 목표는 수십 달러 수준으로 제시되었다. 회사는 이러한 저전력과 저가 사양이 기기 보급에 필수라고 설명하며, 현재 AI 수요의 갈증을 해소할 수 있다고 주장한다.
⏱ 08:007. 3세대 설계 현황
⏱ 08:00회사는 2세대 제품의 설계와 기술 개발이 끝났다고 밝혔다. 이제 공장 투입을 준비하며 사용자가 쓸 수 있는 소프트웨어를 만드는 작업이 남아 있다고 한다.
발표자는 반도체 설계에 버그가 발견되더라도 수정해 마무리할 수 있다는 입장을 보였다. 설계 단계의 불확실성이 어느 정도 해소됐다는 것이 회사의 설명이다.