요약
⏱ 00:001. 칩렛 연결 방식의 전환
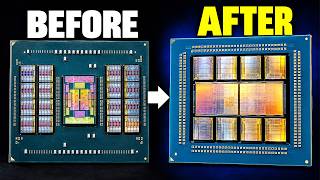
⏱ 00:00AMD가 오랫동안 써 온 핵심 연결 부품을 빼고 256코어 서버 칩을 내놓았다는 소식으로 영상이 시작된다. 기존 칩렛 구조에서는 연산 칩이 패키지 기판의 긴 배선을 거쳐 중앙 IO 다이와 통신했고, 이 과정에서 전력과 시간이 소모됐다.
⏱ 00:502. 노트북 칩 Strix Halo의 성과
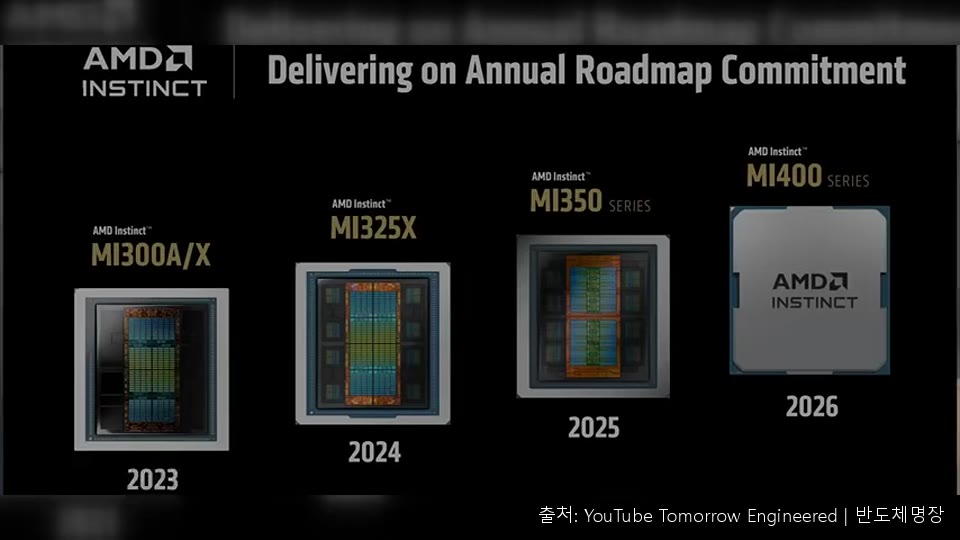
⏱ 00:50첫 적용 제품은 노트북용 Strix Halo로, CPU 칩렛 두 개와 그래픽, 메모리 컨트롤러, AI 엔진이 든 큰 다이를 나란히 배치한 구조다. 128GB 메모리 중 약 96GB를 그래픽 엔진에 할당할 수 있어, 얇은 노트북에서도 700억 파라미터급 언어 모델을 돌릴 수 있다고 소개된다.
독립 테스트에서는 일반 저전력 노트북 칩보다 한 단계 높은 성능을 보였고, 별도 그래픽 카드를 단 대형 기기와도 대등하게 겨뤘다고 한다.
⏱ 01:593. 칩렛으로 나눈 이유: 수율과 비용
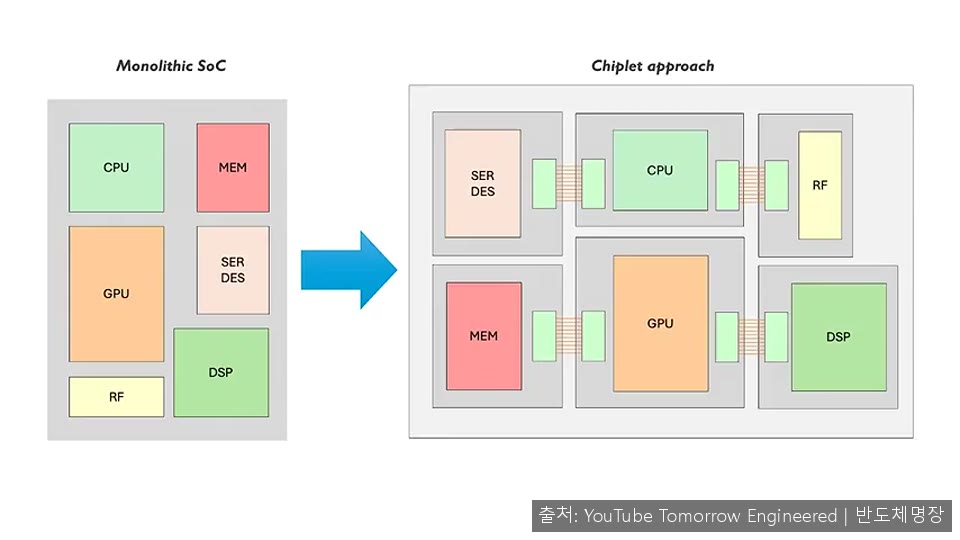
⏱ 01:59AMD는 서버 시장 점유율이 1% 아래로 떨어진 뒤 큰 칩 대신 작은 칩을 여러 개 붙이는 전략을 택했다. 웨이퍼에는 무작위 결함이 섞여 있어 큰 다이일수록 결함에 걸릴 확률이 높고, 작은 칩은 정상품을 더 많이 얻는다.
⏱ 04:524. 기판 배선의 한계와 팬아웃 전환
⏱ 04:52칩렛 사이 신호는 두껍고 간격이 넓은 기판 배선을 지나야 해서 배선 수에 한계가 있었다. AMD는 SerDes로 데이터를 직렬화해 적은 선으로 보냈지만, 링크가 전력을 소모하고 지연을 더하며, 절전 상태에서 깨어날 때 재교육이 필요해 자유로운 절전 전환을 막았다.
Strix Halo에서는 보드를 거치는 경로 대신 칩 바로 아래 미세 배선층에 수백 개의 짧은 배선을 까는 TSMC의 기판 상 팬아웃 방식을 택했다. 짧은 선은 구동 에너지가 적고 패킹 과정이 필요 없어 넓은 병렬 버스 통신이 가능하다. 대가로 칩 아래 공간이 배선으로 붐벼 전력과 신호 배치를 다시 짜야 했다.
⏱ 09:415. 3D 적층과 MI300X의 구조
⏱ 09:41연산 칩 위에 캐시를 쌓는 적층도 함께 발전했다. 라이젠 7 5800X3D는 구리와 구리를 직접 붙이는 하이브리드 본딩으로 납땜볼보다 촘촘한 수직 연결을 구현했고, 2024년 말 7900X3D는 캐시를 아래로 내리고 코어를 쿨러 쪽으로 올려 과열 제약을 줄였다.
⏱ 13:006. Venice와 업계의 확산
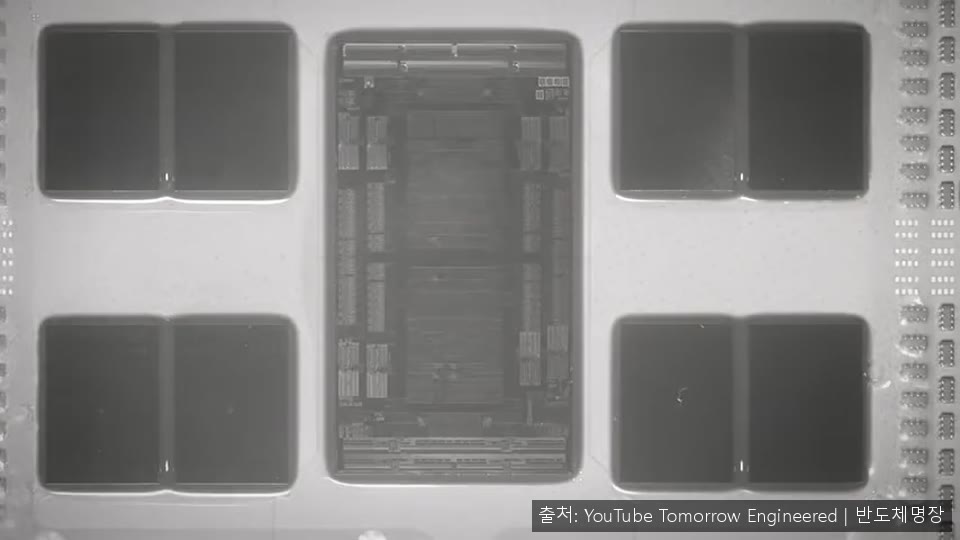
⏱ 13:00올해 7월 공개된 6세대 에픽 Venice는 중앙에 IO 다이 두 개를 두고 주변을 연산 칩렛 8개가 감싸는 구조다. 각 칩렛은 TSMC 2나노 공정으로 만든 코어 32개를 담으며, 최상위 모델은 256코어로 AMD 역사상 가장 많은 코어를 가진 서버 프로세서라고 한다.
인텔은 Clearwater Forest에서 코어 타일을 캐시가 든 베이스 타일 위에 구리 결합으로 쌓는 방식을 택했다. 영상은 ARM 기반 서버 칩도 초봄 출하량의 약 5분의 1을 차지했다고 전하며 경쟁 구도가 넓어졌음을 보여준다. AMD 자체 벤치마크의 높은 처리량 수치는 선택된 작업 부하에 대한 결과라는 단서가 붙는다.
⏱ 17:357. MI455X, 헬리오스 랙과 패키징 병목
⏱ 17:35MI455X는 TSMC 공정의 GPU 칩렛을 구형 공정 베이스 다이 위에 쌓은 구조로, 약 3,200억 개 트랜지스터와 432GB HBM4 메모리를 갖춘다고 소개된다. AMD는 이를 72개 묶은 헬리오스 랙으로 판매하며, 랙 전력이 약 245kW에 달해 액체 냉각 데이터센터가 필요하다.
그러나 AMD는 설계만 하고 제조와 패키징은 TSMC가 맡으며, 패키징 수요가 생산 능력을 웃도는 병목이 보고되고 있다. 세미애널리시스는 MI455X의 제조 문제로 물량 인도가 2027년 2분기로 밀릴 수 있다고 보도했지만, AMD는 이를 부인하고 2026년 하반기 출하 목표를 유지한다고 밝혔다.