요약
중국 스타트업 Iluvatar CoreX가 자사 가속기로 H200과 대등하거나 앞선 성능을 시연했다고 주장한 발표를 다룹니다. 텍스트-이미지 완료율과 MoE 처리량 같은 수치는 흥미롭지만, 독립 검증과 소프트웨어 생태계가 뒷받침되지 않아 하드웨어 전반의 우위로 볼 수는 없다는 것이 핵심입니다.
⏱ 00:001. 논란의 발표 개요
⏱ 00:00상하이 무대에서 두 대의 기계에 같은 AI 모델을 올려 실시간으로 비교한 시연이 이번 논란의 출발점입니다. 한쪽에는 미국의 H200이, 다른 쪽에는 중국 밖에서는 거의 알려지지 않은 Tiangai 300이 놓였습니다.
회사 측은 Tiangai 300이 텍스트-이미지와 텍스트-비디오 생성처럼 까다로운 작업에서 H200을 능가했다고 주장했습니다. 이 주장이 실제 경쟁력인지, 특정 조건에 맞춘 벤치마크의 결과인지가 영상이 던지는 질문입니다.
⏱ 01:142. 시연된 작업 부하와 하드웨어 요구
⏱ 01:14단순한 합성 점수가 아니라 Zhipu의 GLM 5.3 등 실제 모델을 쓴 AI 작업 부하로 시연했습니다. 예를 들어 문단을 입력하면 일관된 이미지를 만들고, 나아가 영상 클립으로 바꾸는 과정입니다.
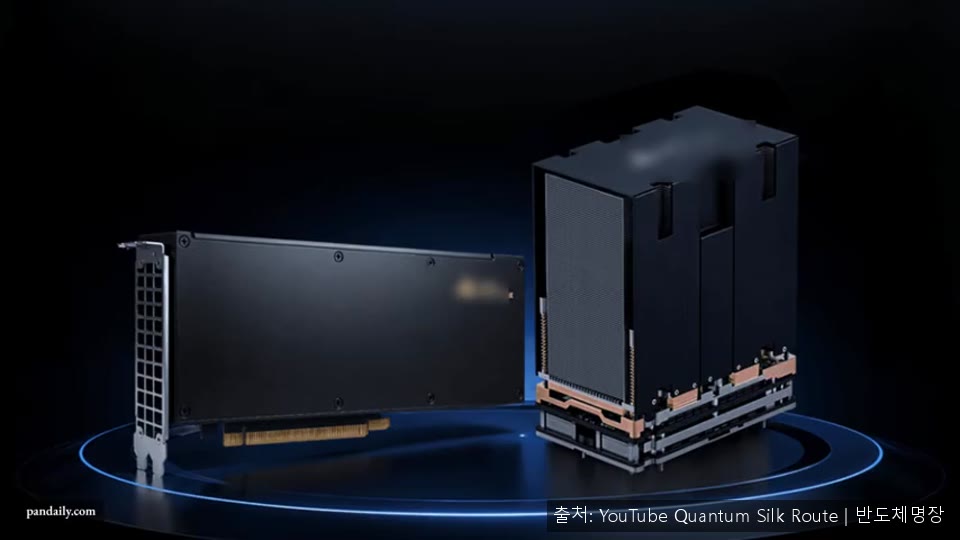
이 과정에서 하드웨어는 거대한 모델, 많은 메모리 요구, 복잡한 연산을 동시에 감당해야 합니다. 데이터를 빠르게 옮기고 모델에 정보를 끊김 없이 공급하며 신경망의 여러 부분을 병목 없이 조율하는 능력이 관건입니다.
⏱ 01:593. 보고된 수치와 시스템 구조
⏱ 01:59보도에 따르면 텍스트-이미지 테스트에서 Tiangai 300은 초당 0.101장으로 완료율 100%를 기록했고, H200은 초당 0.086장에 완료율 87.5%였습니다. 64K 컨텍스트의 MoE 작업에서는 처리량 15% 우위와 첫 토큰 지연 시간 최대 30% 개선도 주장되었습니다.
가장 많이 인용된 1.05배 수치는 프리필·디코드 분리 방식에서 나왔습니다. 프롬프트를 읽는 가속기 그룹과 답변을 한 단어씩 생성하는 그룹을 나누면, 두 작업이 요구하는 하드웨어 특성이 달라 전체 효율을 높일 수 있습니다. 다만 이는 칩 단독 성능이 아니라 시스템 설계의 결과입니다.
같은 결과에서 처리량은 높아도 개별 이미지 하나를 끝내는 데 약 0.64초가 더 걸렸다는 점도 중요합니다. 처리량은 단위 시간당 작업량이고, 완료 시간은 한 작업을 끝내는 데 걸리는 시간이라 데이터센터 고객에게는 둘 다 봐야 합니다.
⏱ 03:294. H200의 구조와 수출 통제 맥락
⏱ 03:29H200은 일반 그래픽 프로세서가 아니라 초대형 AI 모델을 위해 설계된 데이터센터 가속기입니다. 141GB의 HBM3E 메모리를 탑재하고 초당 약 4.8TB의 메모리 대역폭을 제공하는데, 현대 AI에서는 연산 능력만큼 메모리에서 데이터를 얼마나 빨리 보내는지가 성능을 좌우합니다.
⏱ 06:205. 벤치마크 해석의 세 가지 주의점
⏱ 06:20첫째, 결과는 중립적인 시험이 아닙니다. 성능은 프로세서뿐 아니라 소프트웨어 최적화, 컴파일러 효율, 모델 구조, 메모리 관리, 드라이버 품질 등에 크게 좌우됩니다. 특정 모델을 수개월 동안 한 하드웨어에 맞춰 최적화하면 인상적인 수치가 나올 수 있지만, 이것이 모든 작업에서 같은 경쟁력을 뜻하지는 않습니다.
둘째, 시스템 성능과 칩 성능은 다릅니다. 1.05배라는 결과에는 네트워킹, 스케줄링, 배치 소프트웨어, 연산 분산 방식이 함께 들어 있습니다. 시스템 엔지니어링이 뛰어나 특정 구성에서 이긴 것일 수는 있으나, 그 자체로 프로세서가 더 강하다는 증거는 아닙니다.
셋째, 독립 검증이 부족합니다. 전력 소비, 양자화 방식, 배치 크기, 냉각, 소프트웨어 버전, 양측의 최적화 수준 같은 세부 조건이 공개되어야 비교가 가능합니다. 중국 생태계 밖에서의 독립 테스트도 필요하지만 아직 확인되지 않았습니다. 또한 대규모 생산 능력, 토큰당 비용, 장기 신뢰성은 입증되지 않았습니다.
⏱ 11:006. 지정학적 의미와 생태계 과제
⏱ 11:00워싱턴은 최첨단 컴퓨팅 접근을 제한해 중국의 AI 발전을 늦추려 하고, 베이징은 국산 대안을 키워 그 효과를 줄이려 합니다. 중국 내 Biren, MetaX, Enflame, Moore Threads, Iluvatar 같은 기업들과 화웨이 Ascend가 이 흐름에 참여하고 있습니다. 모든 작업에서 엔비디아를 넘을 필요는 없고, 특정 MoE 같은 워크로드에서 국내 고객이 고려할 만큼 충분히 좋고 안정적이면 의미가 큽니다.