
요약
칩 성능 향상은 트랜지스터를 줄이는 일이었다. 디나드 스케일링이 전압 정체로 멈추자 클록이 고정되고 병렬 코어가 늘었으며, 누설을 막기 위해 트랜지스터는 입체 구조로 바뀌었다. 영상은 CV² 계산과 0.7배 축소 산수로 이 흐름을 단계별로 보여준다.
⏱ 00:001. 두 조각으로 나뉜 칩이 던지는 질문
⏱ 00:00영상은 최신 AI 칩 블랙웰(Blackwell)이 왜 두 개의 실리콘 조각을 나란히 붙인 구조인지부터 묻는다. 두 조각은 초당 10테라바이트를 주고받는 링크로 연결되고, 주변에는 메모리 스택이 쌓여 있다. 2023년 AI 칩 수요가 폭발했을 때 병목은 칩을 찍어내는 단계가 아니라, 완성된 GPU와 메모리를 하나의 기판에 올리는 후공정이었다고 설명한다.
두 질문의 뿌리는 같다고 영상은 말한다. 칩은 빛으로 찍어 올린 수십억 개 부품의 그림이고, 성능을 높이는 것은 그 그림을 더 작게 그리는 일이었다. 미세화할수록 완벽한 복제 확률은 떨어지고, 그 기술을 소수 기업만 해낼 때 공급망은 쉽게 막힌다.
⏱ 02:042. 스위치 하나를 켜는 데 드는 비용
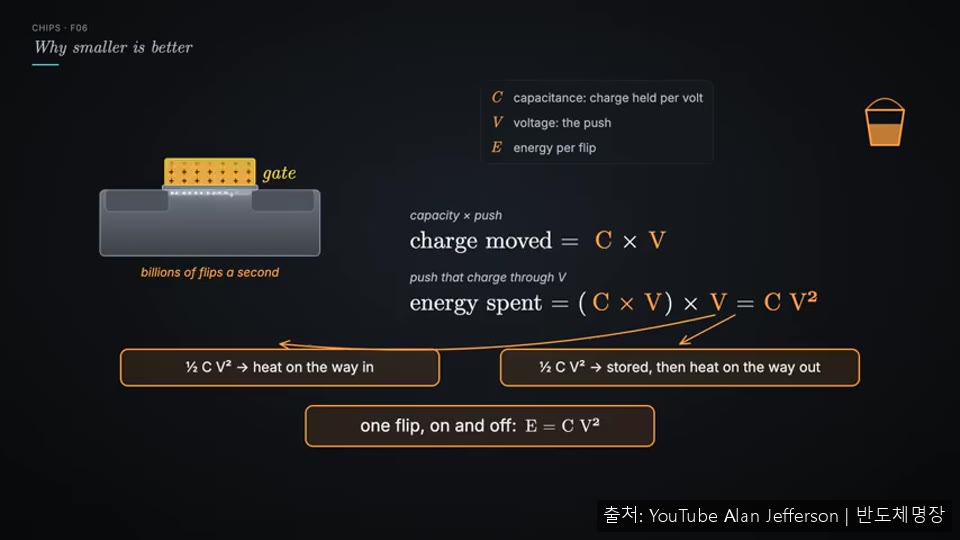
⏱ 02:04트랜지스터는 가동 부품 없이 게이트 전압으로 전류를 켜고 끄는 스위치다. 게이트는 실리콘 위의 얇은 산화막 위에 놓여 있고, 켜려면 게이트에 전하를 밀어 넣어 그 아래 전자를 끌어올린다. 끌 때는 전하를 빼낸다. 즉 한 번 켜고 끌 때마다 작은 전하 통을 채웠다 비우는 셈이다.
이 통이 전압 1볼트당 담는 전하량을 정전용량(capacitance)이라 한다. 게이트 면적이 클수록, 산화막이 얇을수록 정전용량은 커진다. 전하 C를 전압 V로 채우는 데 드는 에너지는 CV²이며, 그 절반은 게이트에 저장되고 나머지는 배선에서 열로 사라진다. 칩이 쓰는 전력의 큰 몫은 이 CV²가 수십억 개 스위치에서 초당 수십억 번 반복되는 것이다.
⏱ 04:243. 축소의 산수와 디나드 스케일링
⏱ 04:24영상은 모든 길이를 0.7배로 줄이는 세대 교체를 계산한다. 0.7 곱하기 0.7은 약 0.5이므로 면적이 절반이 되어 같은 공간에 두 배의 트랜지스터가 들어간다. 정전용량은 면적 감소와 산화막 두께 증가가 맞물려 0.7배가 되고, 전압도 0.7배로 낮아진다. 그러면 한 번의 스위칭 에너지는 약 3분의 1로 줄어든다. 전류는 0.7배로 줄어 스위칭 시간이 약 0.7배가 되고, 클록은 약 1.4배까지 빨라질 수 있다. 제곱밀리미터당 전력은 약 1로 유지된다.
이 규칙은 1974년 IBM의 로버트 데나드(Robert Dennard)와 동료들이 발표한 상수 전계 축소, 즉 디나드 스케일링이다. 데나드는 1968년 트랜지스터 하나와 축전기 하나로 1비트를 저장하는 DRAM 셀 특허를 받았고, 이 셀은 HBM 안에 쌓이는 DRAM의 원형이다. 전압과 길이를 함께 줄여 전기장을 일정하게 유지하는 것이 이 규칙의 핵심이다.
⏱ 09:274. 전압이 멈추자 열이 늘었다
⏱ 09:272000년대 초 전압 축소가 멈춘 이유는 누설 전류다. 스위치는 완전히 꺼지지 않아 문턱 전압 아래에서도 전류가 새며, 실온에서 60밀리볼트마다 누설은 최대 10배 정도만 줄어든다. 이 기울기는 전자의 열 진동이 정한 물리적 하한이라 일반 트랜지스터로는 넘을 수 없다. 따라서 전압을 더 내리면 스위치가 제대로 꺼지지 않은 채 전력만 쓰게 된다.

전압이 줄지 않으면 세대마다 제곱밀리미터당 열이 약 1.4배로 늘어난다. 클록을 두 배로 올리면 거의 세 배가 되어 칩이 타버린다. 영상은 2004년 인텔이 차세대 펜티엄 4를 취소하고 두 코어 칩으로 방향을 바꾼 사례를 들고, 이를 분석가들이 열 문제와 연결했다고 전한다. 스탠퍼드의 마크 호로위츠(Mark Horowitz)는 이를 전력의 벽이라 불렀다. 이후 트랜지스터는 병렬 코어와 유휴 시 꺼지는 회로에 쓰였고, 이것이 GPU의 수천 개 연산 레인으로 이어졌다.
⏱ 13:535. 입체 구조와 후면 배선으로 누설을 막다
⏱ 13:53평면 트랜지스터는 게이트가 채널 위쪽에만 닿아, 채널이 짧아지면 먼 쪽 전류가 게이트 제어를 벗어나 새어 나온다. 해법은 게이트가 채널을 더 많이 잡게 하는 것이었다. 얇은 실리콘 핀을 세우고 게이트로 세 면을 감싸는 FinFET이 1998~1999년 히타치와 UC 버클리 연구진에 의해 발표되었고, 인텔은 2011년 22나노에서 트라이게이트라는 이름으로 양산에 적용했다. 이후 핀을 얇은 시트 여러 장으로 나눠 사방을 감싸는 게이트올어라운드(GAA), 즉 나노시트가 등장했다. 삼성은 2022년 3나노에서 이를 양산했고, TSMC 2나노와 인텔 RibbonFET도 같은 계열이다. 전원선을 웨이퍼 뒷면으로 옮기는 후면 전력 배선도 도입되었다.
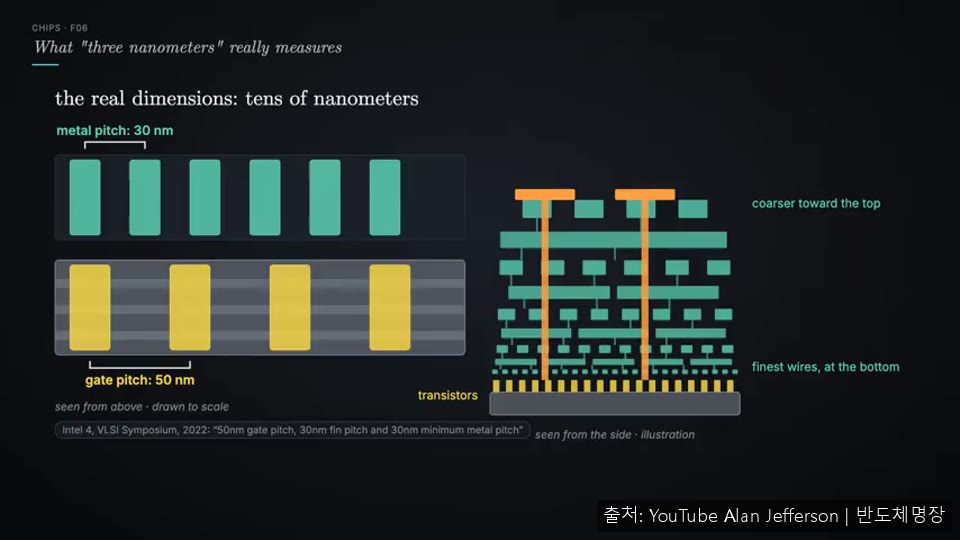
영상은 나노미터 이름이 실제 크기가 아니라는 점도 계산으로 보여준다. H100은 약 800억 개 트랜지스터를 814제곱밀리미터에 담아 제곱밀리미터당 약 9,800만 개이고, 트랜지스터 하나는 약 1만 제곱나노미터, 한 변 약 100나노미터의 면적을 쓴다. 실제 치수는 수십 나노미터 수준이며, 회사들은 게이트 피치와 금속 피치 같은 지표를 공개한다.


