요약
⏱ 00:001. 도입과 AMD의 주장
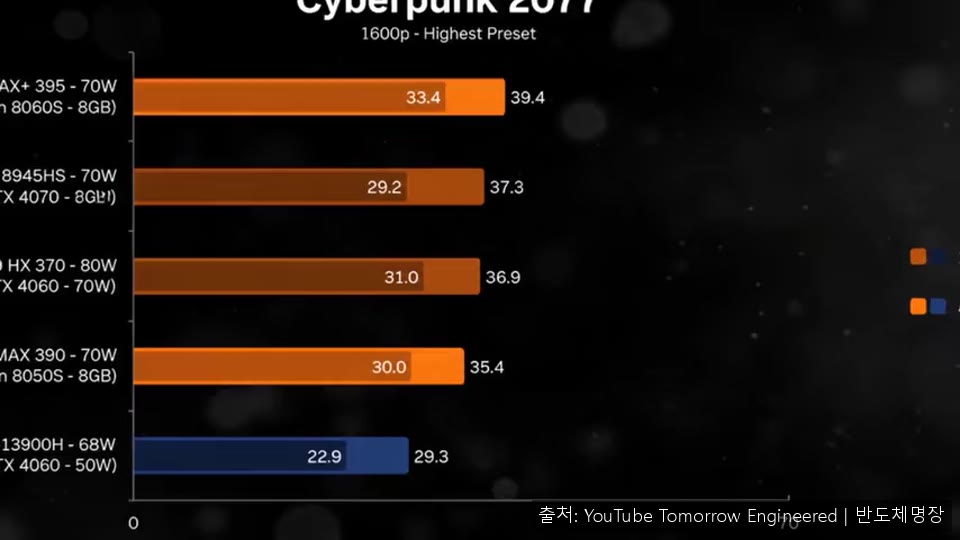
⏱ 00:00AMD의 Ryzen AI Max+ 395는 데스크톱급 그래픽 엔진을 프로세서 패키지에 내장한 칩이다. 이 칩을 탑재한 ASUS ROG Flow Z13은 사이버펑크 2077 테스트에서 RTX 4070 노트북보다 나은 성능을 보였다고 소개된다.
⏱ 00:552. 내장 그래픽의 메모리 병목
⏱ 00:55게이밍 노트북의 외장 GPU는 GPU와 직접 연결된 고속 전용 메모리를 갖추고 있다. 반면 APU는 옆의 CPU 코어와 일반 시스템 메모리를 공유하므로, 데이터가 늦게 오면 성능이 아무리 좋아도 GPU가 놀게 된다.
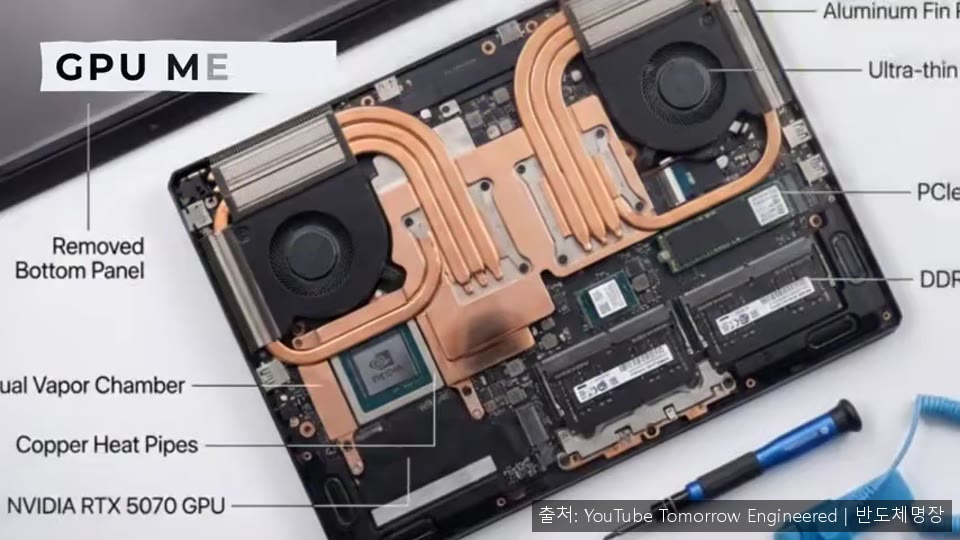
영상은 이 메모리 문제를 해결했는지가 내장 그래픽의 가능성을 가르는 질문이라고 본다.
⏱ 03:163. 칩 구조와 전력 효율
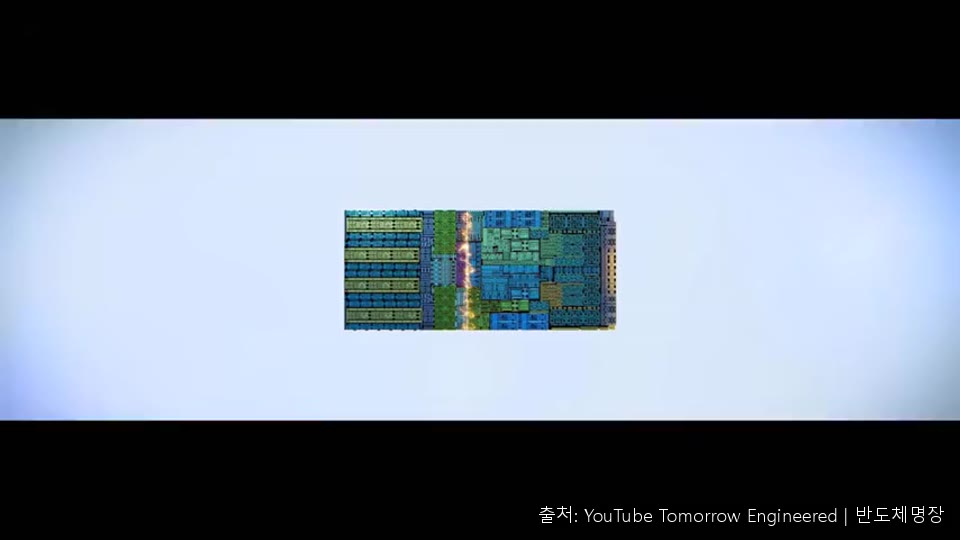
⏱ 03:16패키지를 열면 큰 그래픽 다이 옆에 Zen 5 CPU 칩렛 두 개가 놓여 있다. CPU 칩렛은 데스크톱 라이젠과 같은 코어를 쓰지만, 큰 다이와 연결되는 방식을 새로 설계해 데이터 이동 속도는 유지하고 전력 소모는 줄였다.

⏱ 05:034. 넓은 메모리 버스와 인피니티 캐시
⏱ 05:03AMD는 일반 노트북 칩보다 두 배 넓은 메모리 버스를 설계했다. 저전력 LPDDR5X를 기반으로 하며, 넓은 버스를 만들려면 대역폭 구간마다 메모리 컨트롤러가 필요해 다이 면적과 비용이 커진다. 이렇게 해서 초당 256GB 전송을 목표로 한다.
그래도 원시 대역폭은 소니 PS5의 약 448GB/s보다 낮다. 이를 보완하는 것이 그래픽 엔진 옆의 32MB 인피니티 캐시다. 독립 분석 업체 Chips and Cheese는 이 캐시가 메인 메모리 대역폭의 거의 4배에 달하는 속도를 낸다고 측정했다. 자주 쓰는 텍스처와 장면 데이터를 가까이 두어 메모리까지 가는 횟수를 줄이는 방식이다.
⏱ 07:335. 공유 메모리 용량과 LLM 추론 테스트
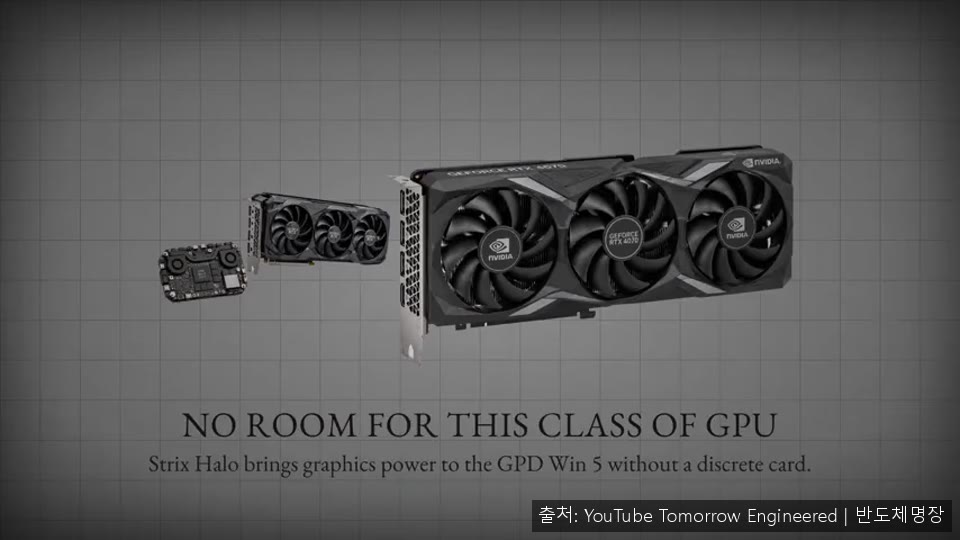
⏱ 07:33일반 그래픽 카드는 메모리 용량이 카드에 납땜되어 고정되어 있다. RTX 4090은 32GB다. 반면 이 칩은 CPU와 그래픽이 최대 128GB를 공유하며, 윈도우에서는 그래픽 엔진이 최대 96GB를 자체 메모리로 쓸 수 있다.
AMD는 2025년 CES에서 Llama 3.1 70B 모델로 테스트해 RTX 4090보다 2.2배 빠르게 텍스트를 생성했다고 밝혔다. 다만 모델이 24GB 메모리를 넘어서 일부가 느린 시스템 메모리로 넘어가는 조건이었다는 점을 영상은 짚는다. 이후 드라이버 업데이트로 최대 1,280억 파라미터 모델까지 로드할 수 있게 되었다.
⏱ 11:546. 경쟁 구도: Apple, Intel, Nvidia
⏱ 11:54Apple의 M5 Max는 Strix Halo와 비슷한 용량에서 초당 614GB의 대역폭을 제시해 순수 텍스트 생성 속도에서 앞선다. Intel의 Panther Lake도 내장 Arc B390 그래픽으로 보급형 노트북 GPU에 근접한 성능을 보였다. Nvidia는 DGX Spark와 RTX Spark를 내놓으며 CUDA 소프트웨어 생태계와 ARM 기반 노트북 칩으로 맞섰다.
토큰 생성 속도는 AMD와 Nvidia 제품이 거의 비슷했다. 메모리 통로 폭이 비슷하기 때문이다. 입력 처리 속도에서는 Nvidia 블랙웰 GPU가 연산 능력 덕분에 긴 프롬프트에서 훨씬 빠르다. AMD의 ROCm은 파인튜닝 같은 일부 작업에서 CUDA보다 까다롭다는 평가다.
⏱ 18:287. 한계와 메모리 가격 문제
⏱ 18:28영상은 AMD가 메모리 문제를 해결한 것이 아니라 관리한 것이라고 정리한다. 최상급 성능에서는 RTX 5090의 메모리 대역폭이 AMD보다 약 7배 빠르고, 대형 모델에서는 여러 중고 GPU를 묶은 장비가 더 빠르지만 전력과 소음이 훨씬 크다.
또한 메모리가 보드에 납땜되어 있어 나중에 증설할 수 없고, AI 데이터센터의 메모리 수요가 늘면서 기기 가격에도 영향이 나타났다. 프레임워크는 최대 메모리 데스크톱 가격을 1,999달러에서 2,459달러로 올렸다고 소개된다.